Как я сократила разбор скана с 6–8 до 2–3 часов с помощью AI в CoPilot
CoPilot прогоняет отчёт сканера безопасности через три движка — RL-модель, LLM и Advice service — и помогает аналитику быстро отделить реальные уязвимости от ложных срабатываний. Я спроектировала продукт от задачи до передачи в разработку.
- Роль
- Разбирала рабочие сценарии с аналитиками и PM. Спроектировала настройку AI-проверки, мониторинг обработки и разбор находок, включая состояния, ошибки и действия эксперта; передала дизайн в разработку.
- Команда
- 9 человек: я (дизайнер), PM, аналитик, 2 фронтендера, 2 бэкендера, 2 QA
- Продукт
- AppSec Solutions, cybersecurity, B2B SaaS, веб
- Результат
- ≈ −60% времени на разбор большого скана (с 6–8 до 2–3 часов); ≈ 2 из 3 находок закрываются без открытия кода
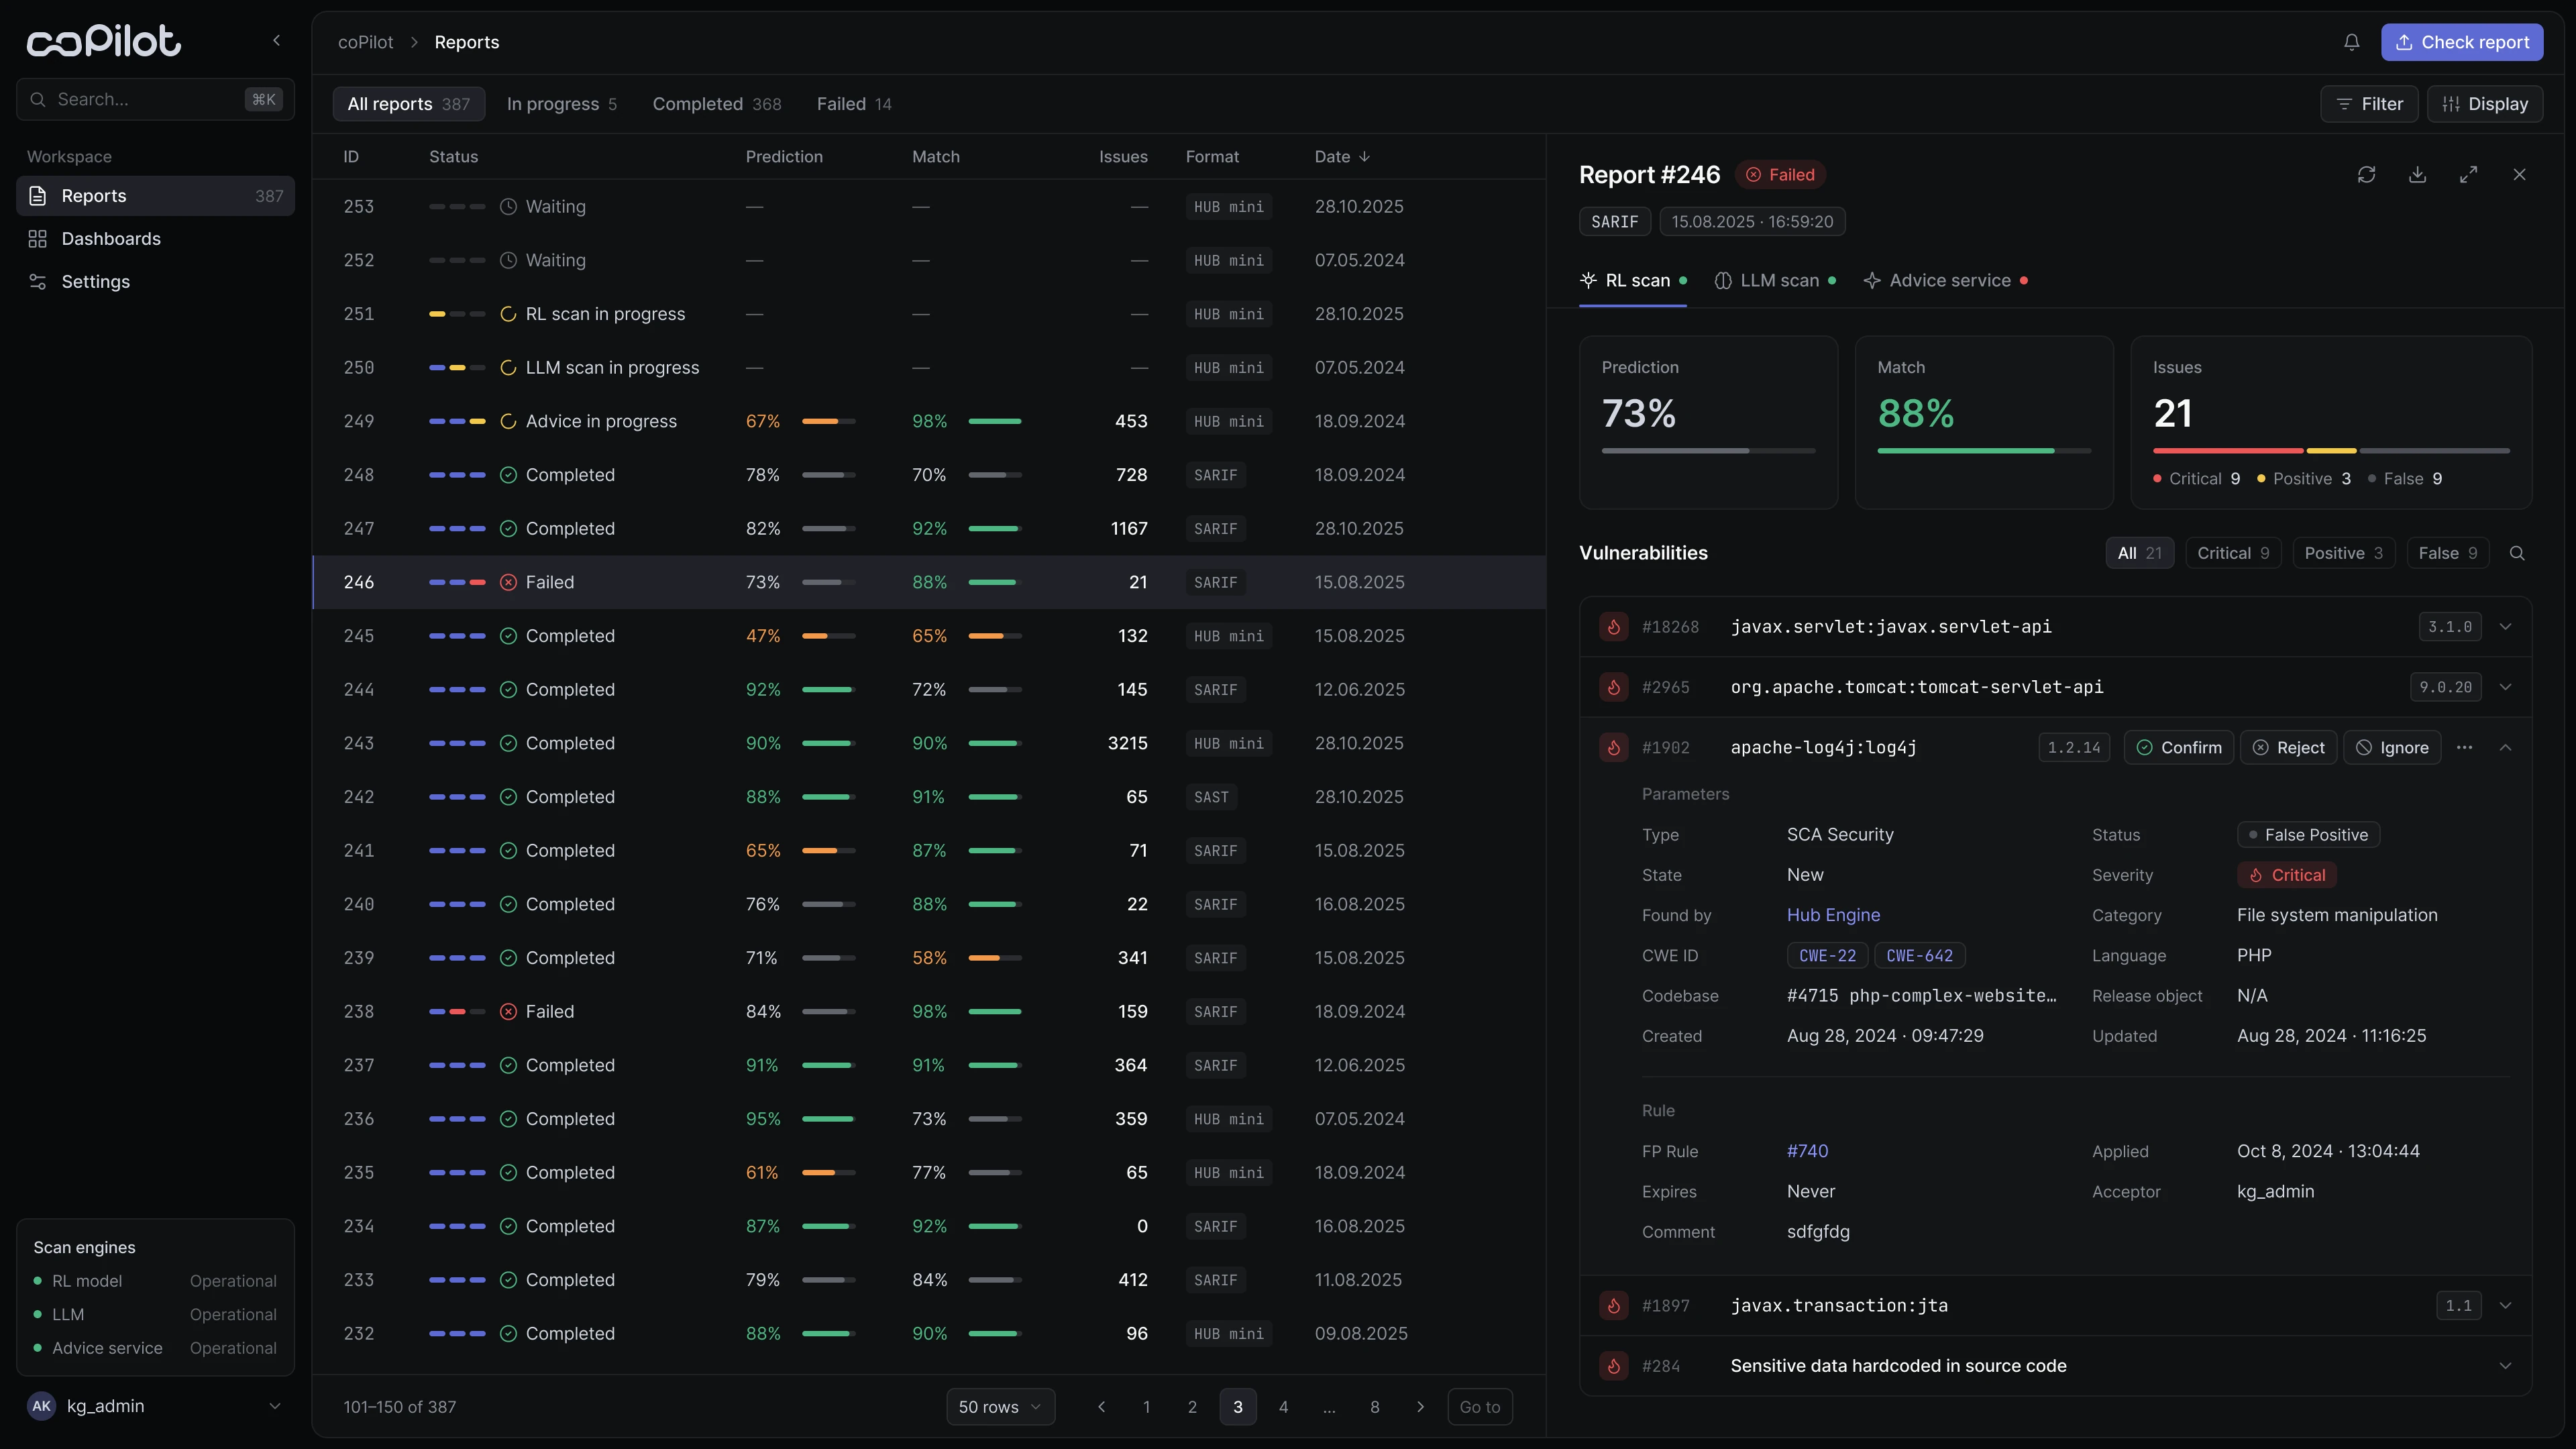
 Светлая
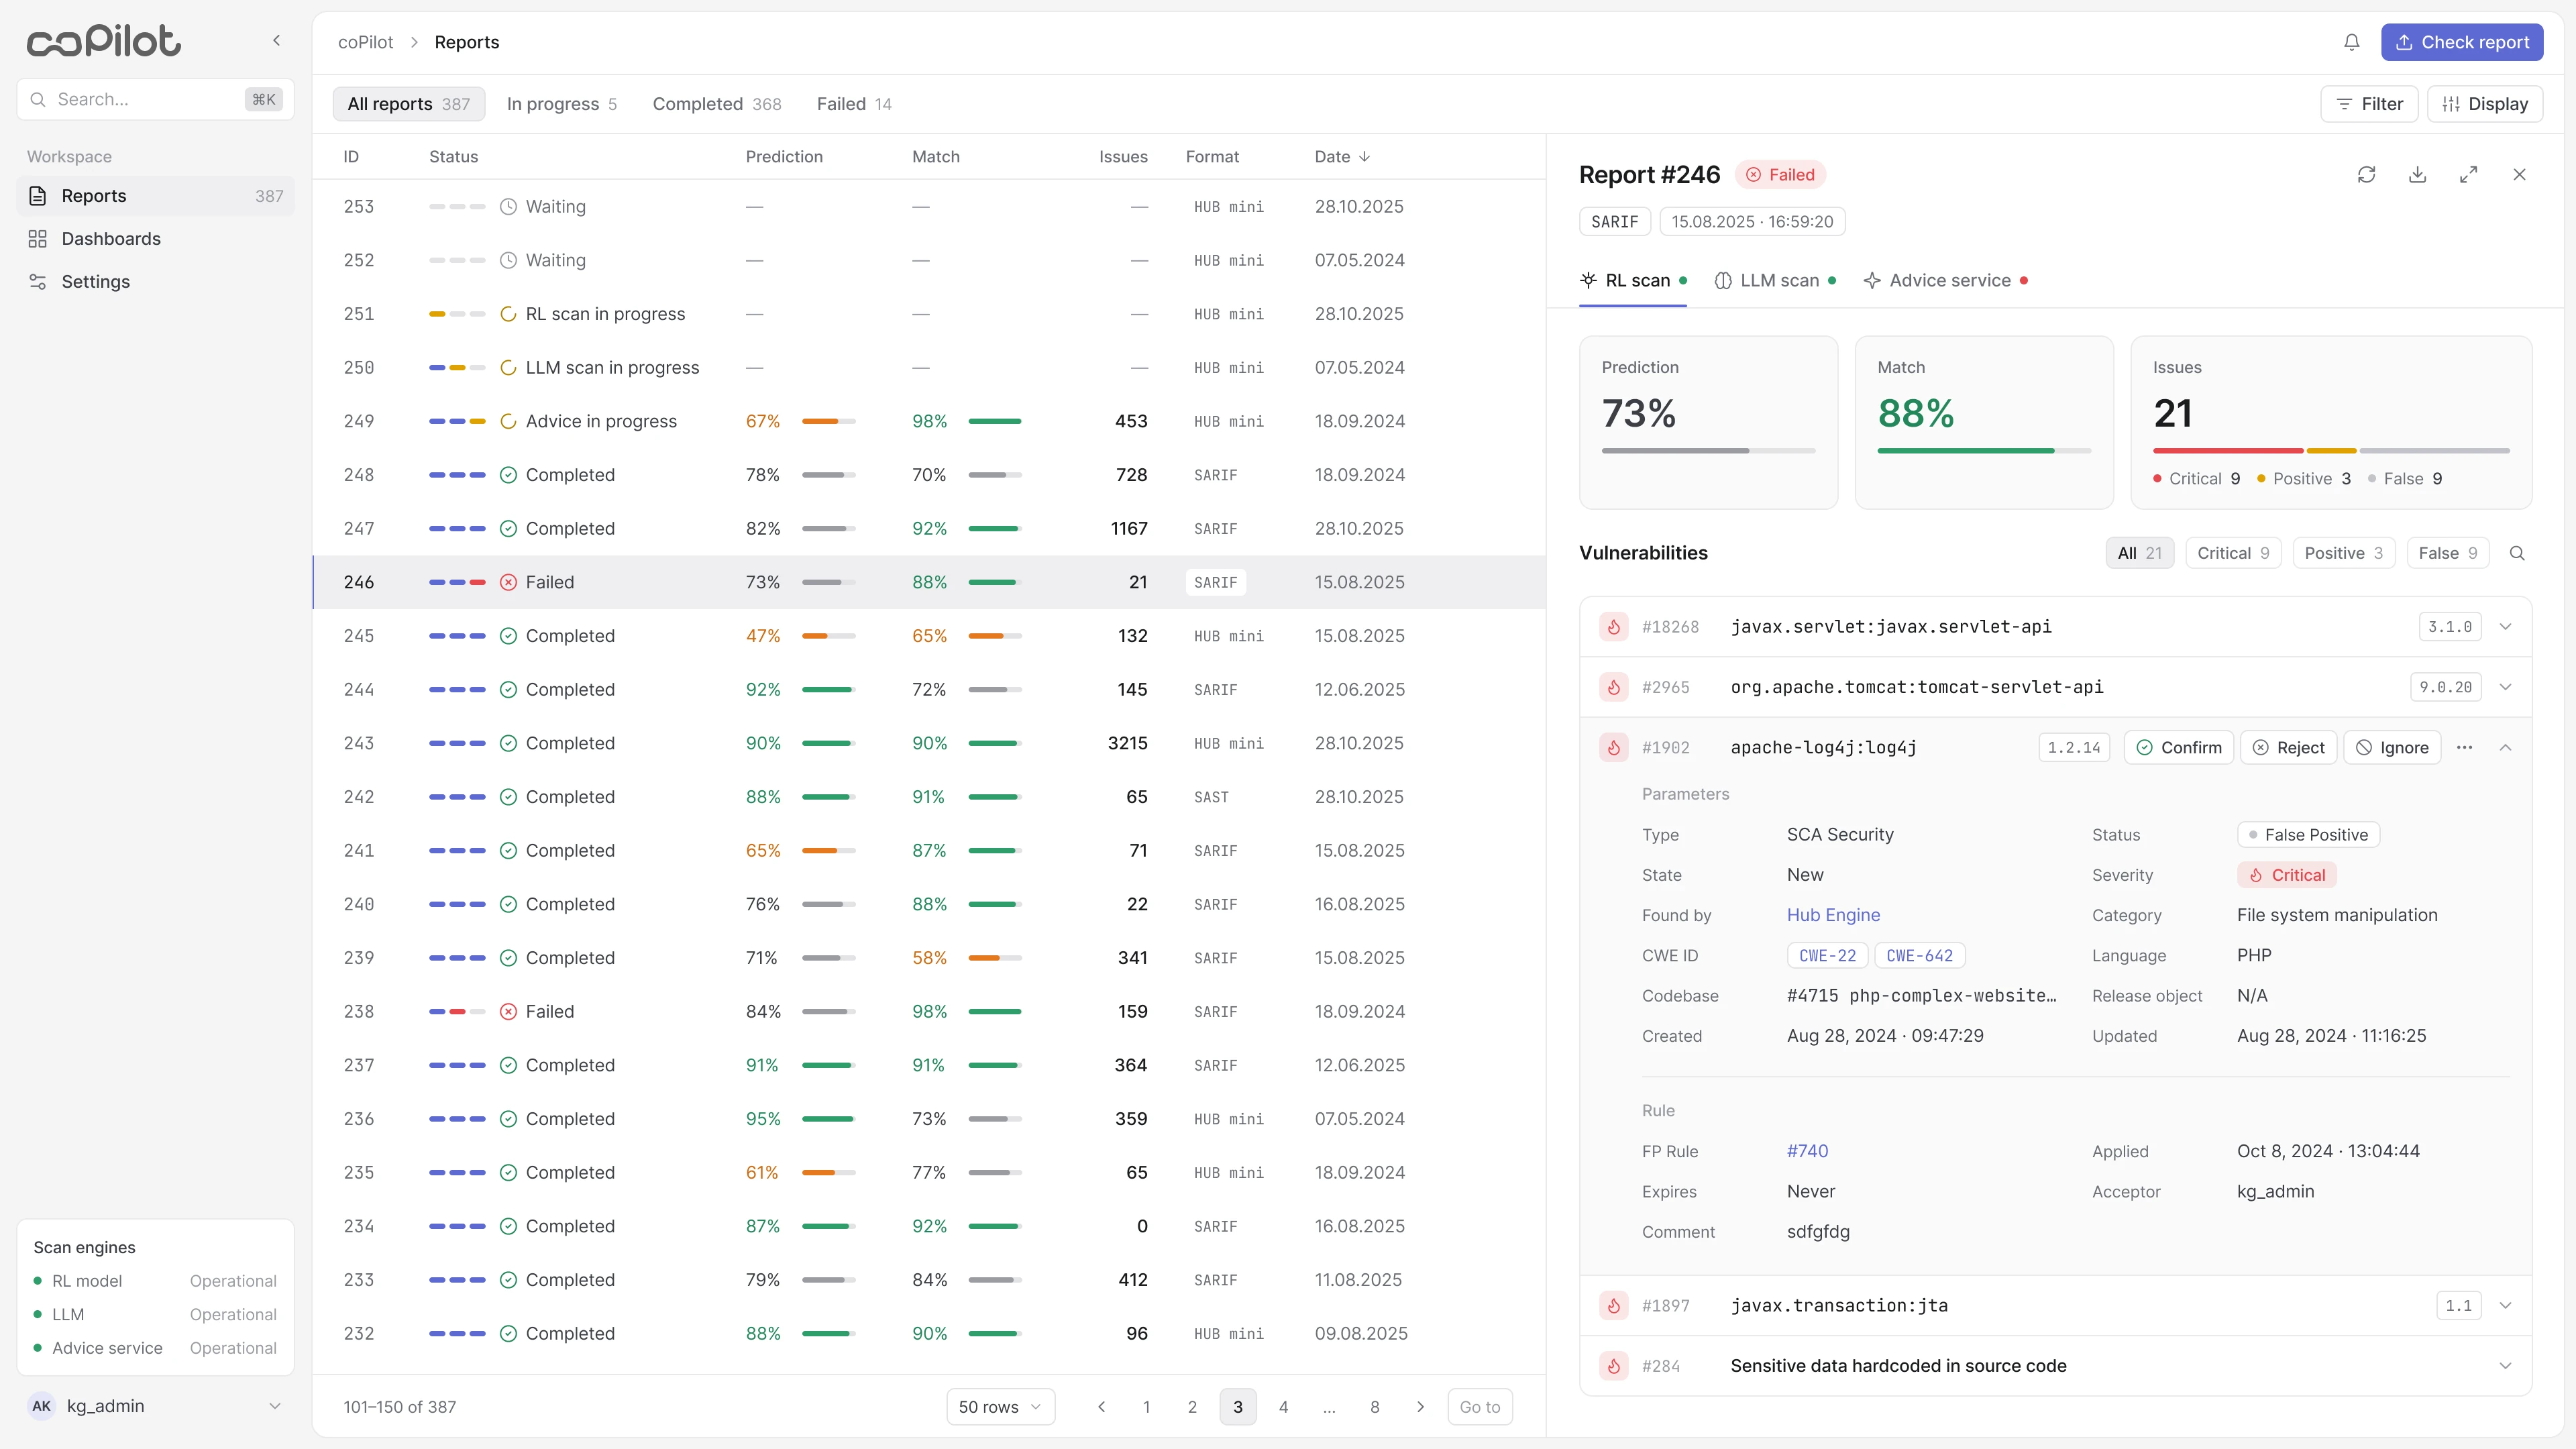
Тёмная
Контекст
После каждого скана аналитик получал сотни находок, и разбор одного скана занимал 6–8 часов.
AI мог ускорить работу, но только если интерфейс в любой момент отвечает на три вопроса:
Исследование
Я регулярно созванивалась с аналитиками и разбирала сценарии с PM. Главные выводы:
- Без статуса нет доверия. Эксперту нужно видеть, на каком этапе проверка и где сбой.
- Прогноз легко принять за вердикт. Оценку AI и решение человека нужно явно разделить.
- Находок сотни, а время эксперта ограничено. Доказательства для решения должны быть в одном месте.
Ключевые решения
Несколько сигналов, а не один бейдж. Prediction, Match и результаты каждого движка показаны раздельно, чтобы аналитик проверял логику, а не верил выводу на слово. Расхождение сигналов видно сразу.
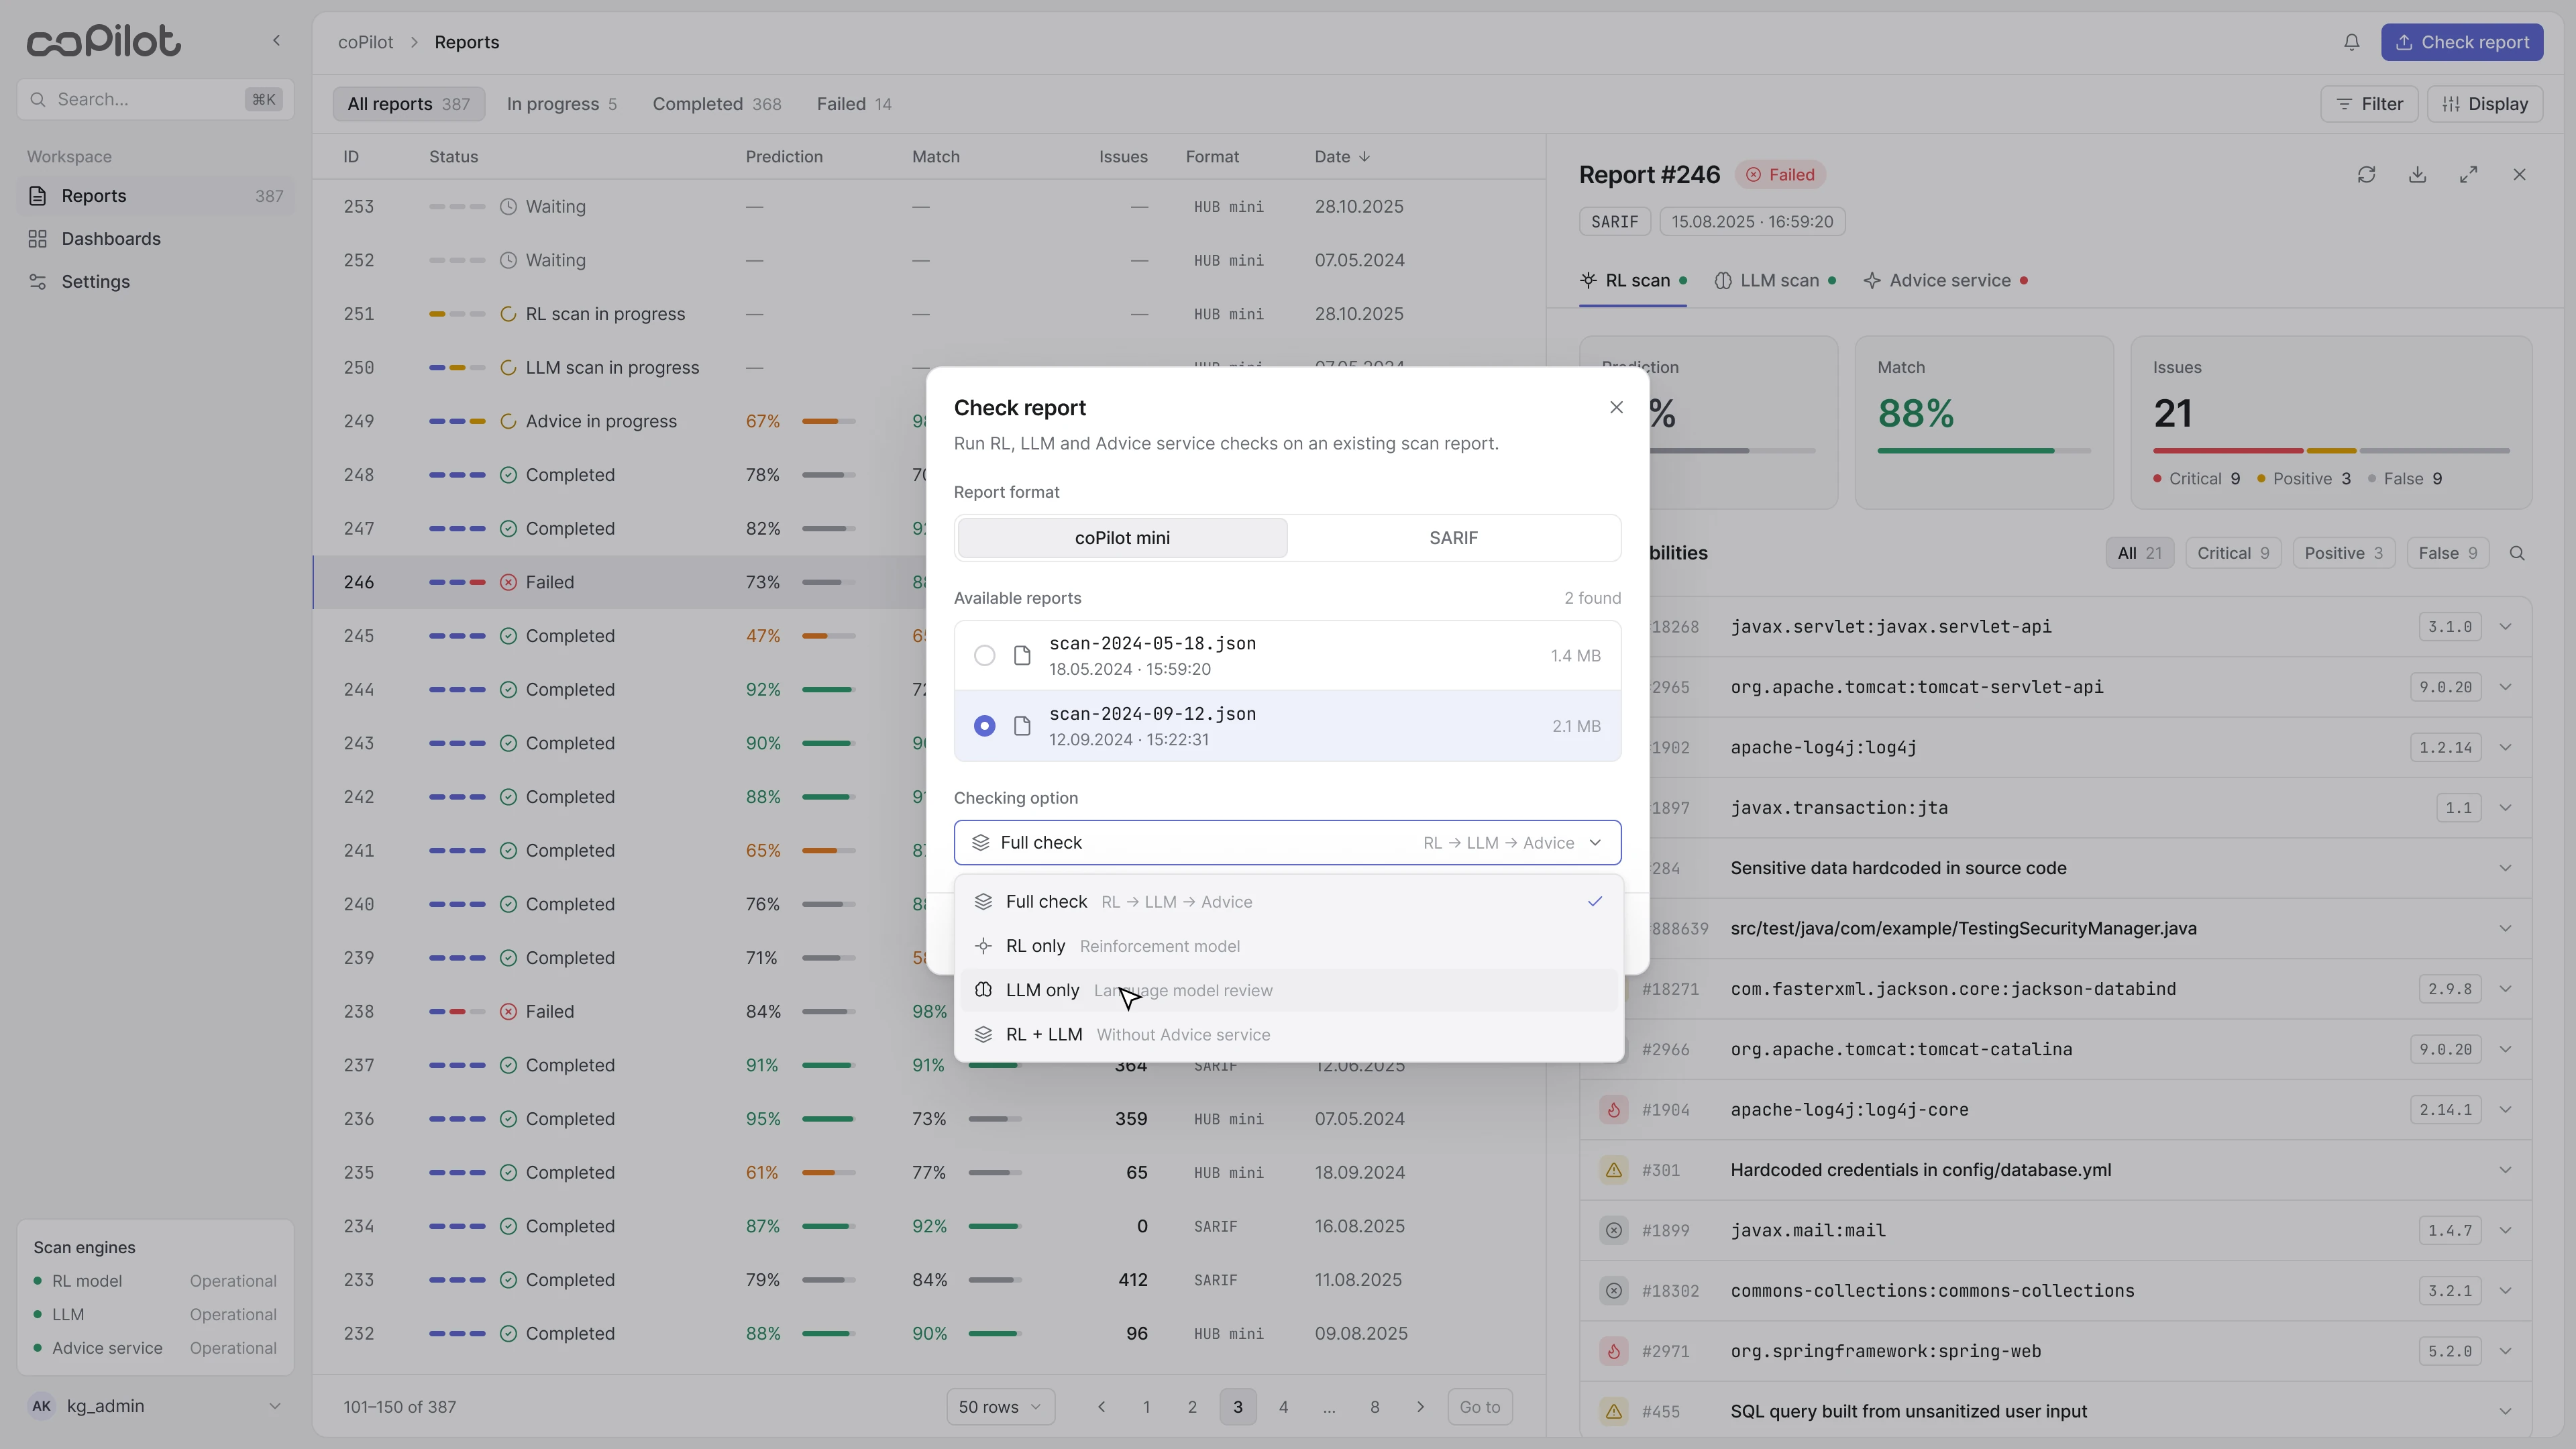
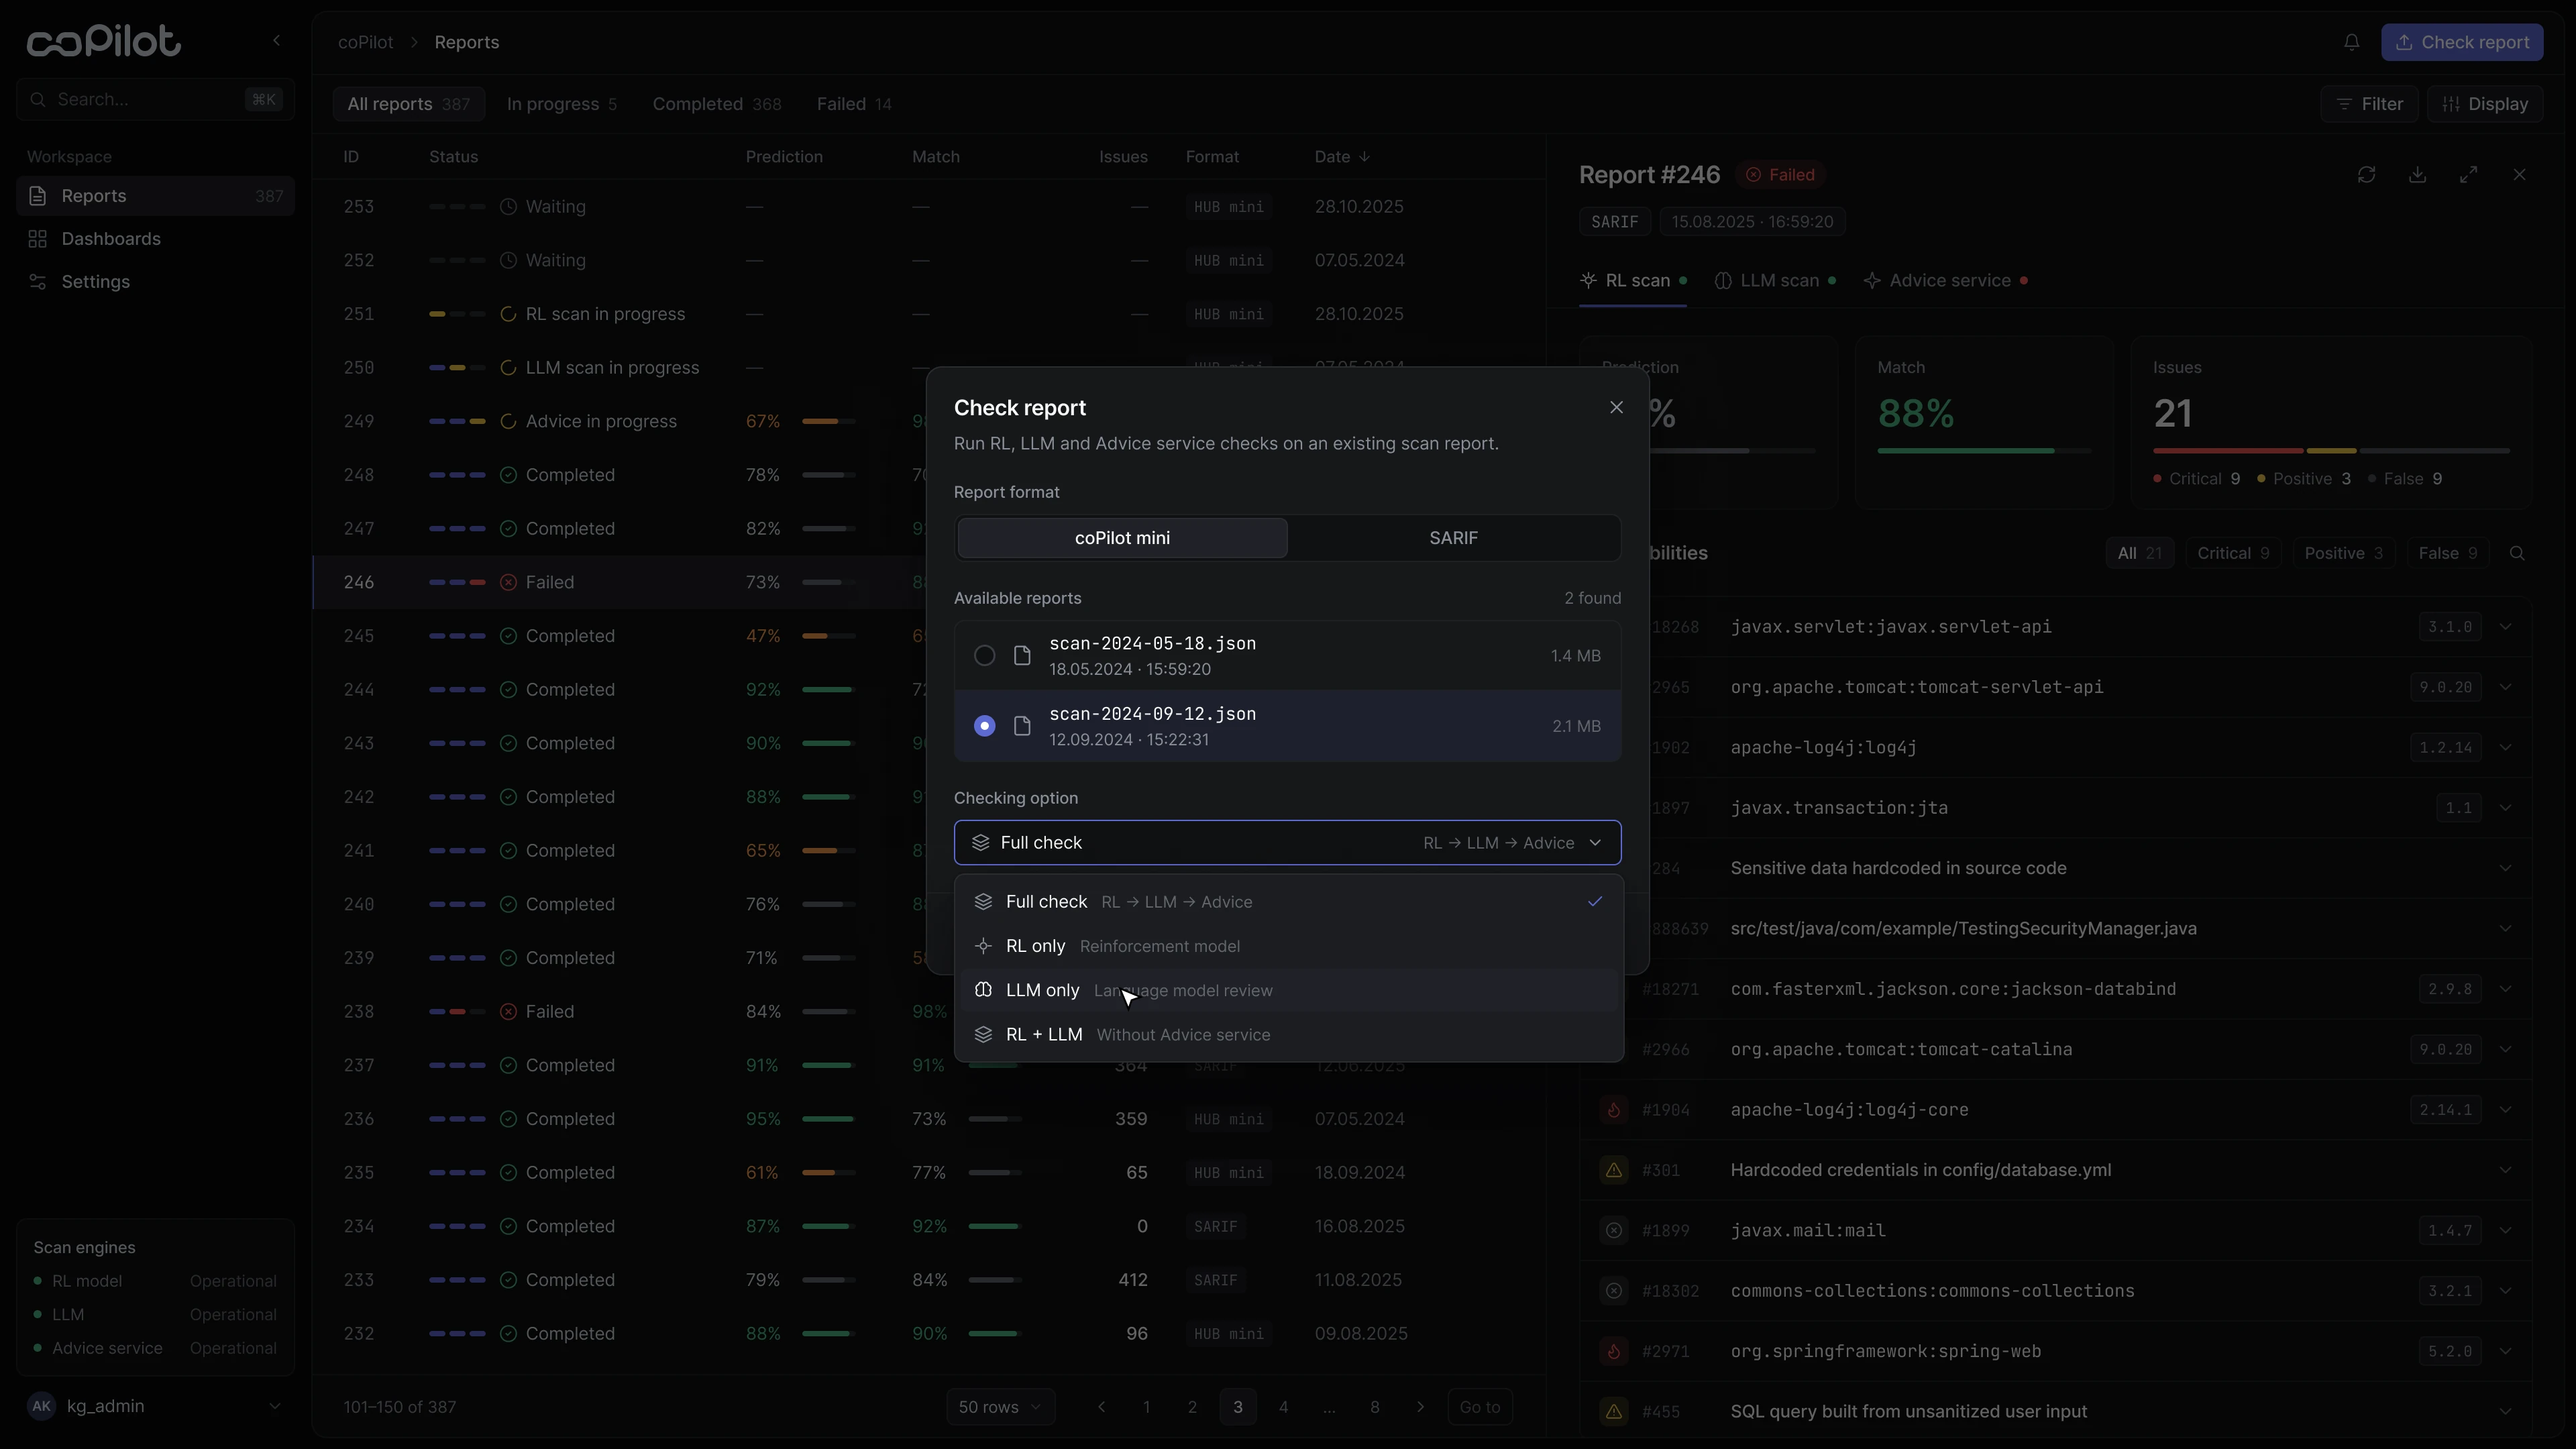
Выбор глубины проверки, а не всегда полный анализ. Быстрый разбор и глубокая проверка решают разные задачи, поэтому перед запуском можно выбрать полную проверку или отдельные движки.
Решение за человеком, а не автозакрытие по порогу. Автозакрытие нельзя защитить на аудите, а один ложноотрицательный результат означает пропущенную реальную уязвимость.
Модель сценария
Сценарий разделён на два режима: мониторинг и разбор.
01Контроль до запуска проверки
Всё, что влияет на результат, собрано в одном окне: формат отчёта, сам отчёт и глубина проверки — от полной (RL → LLM → Advice) до отдельных движков. У каждого режима есть короткое пояснение, поэтому выбор понятен без документации.
02Прозрачная фоновая обработка
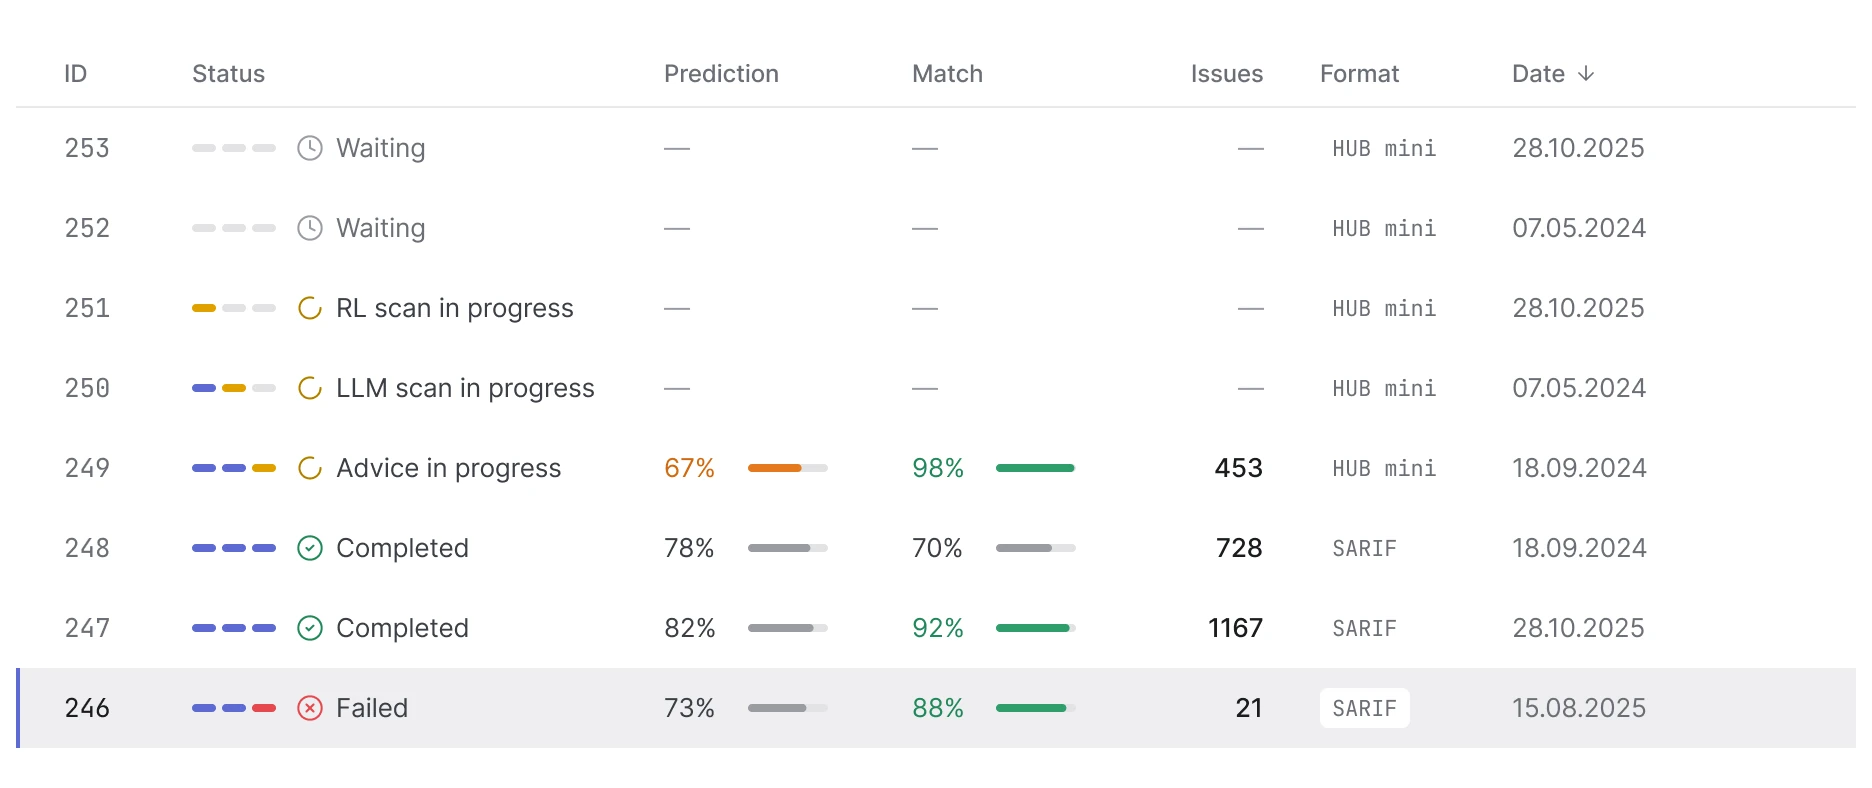
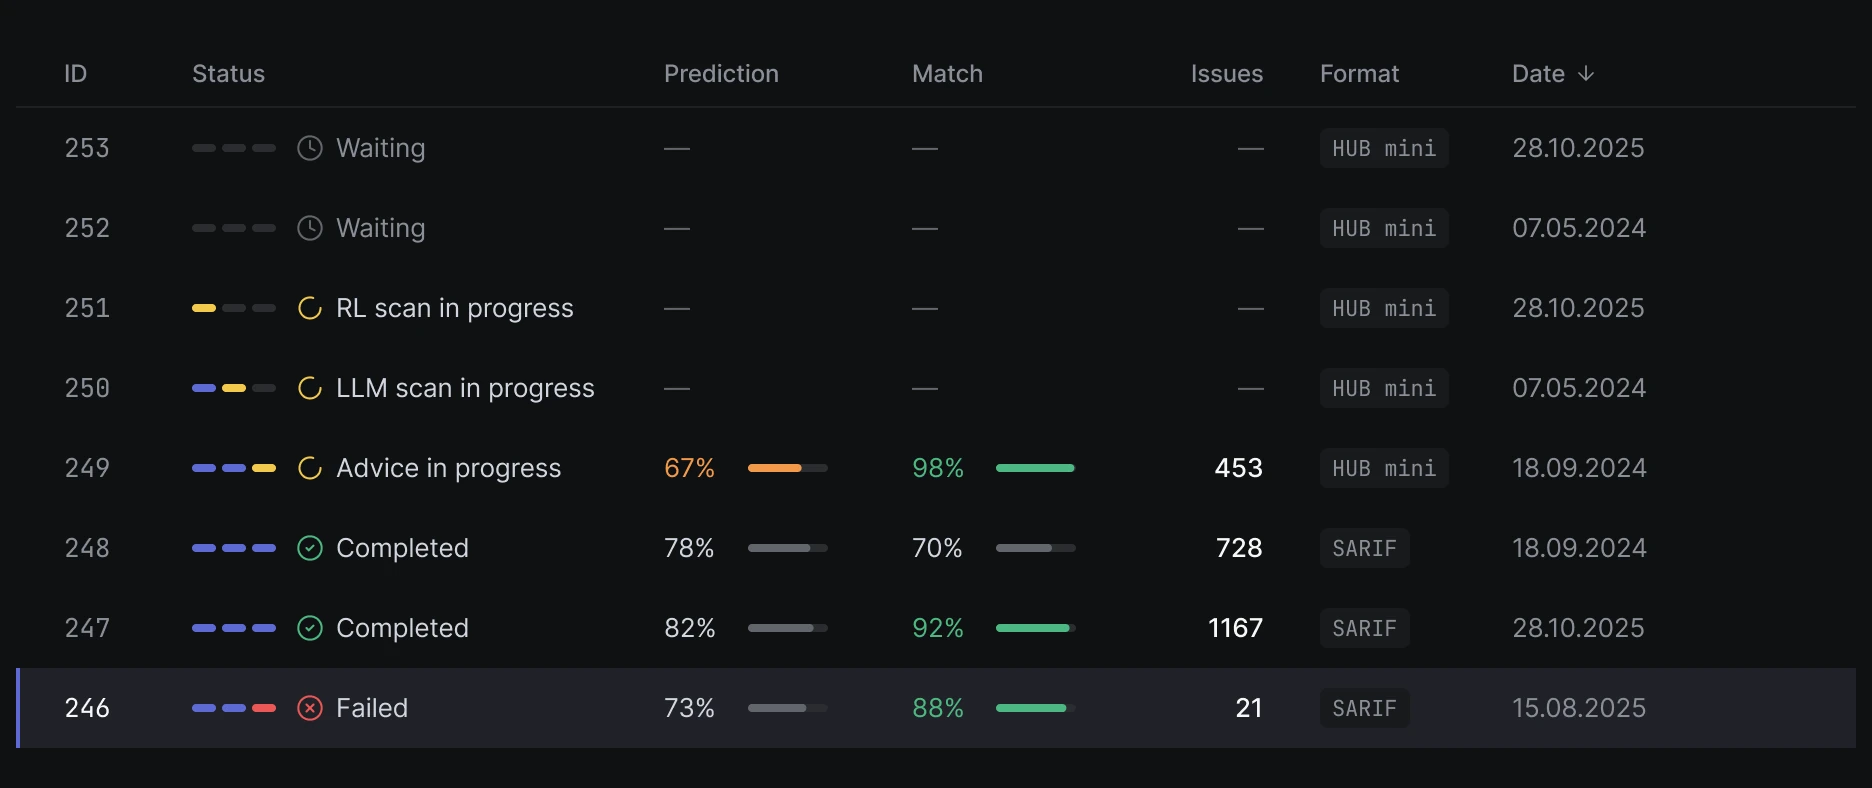
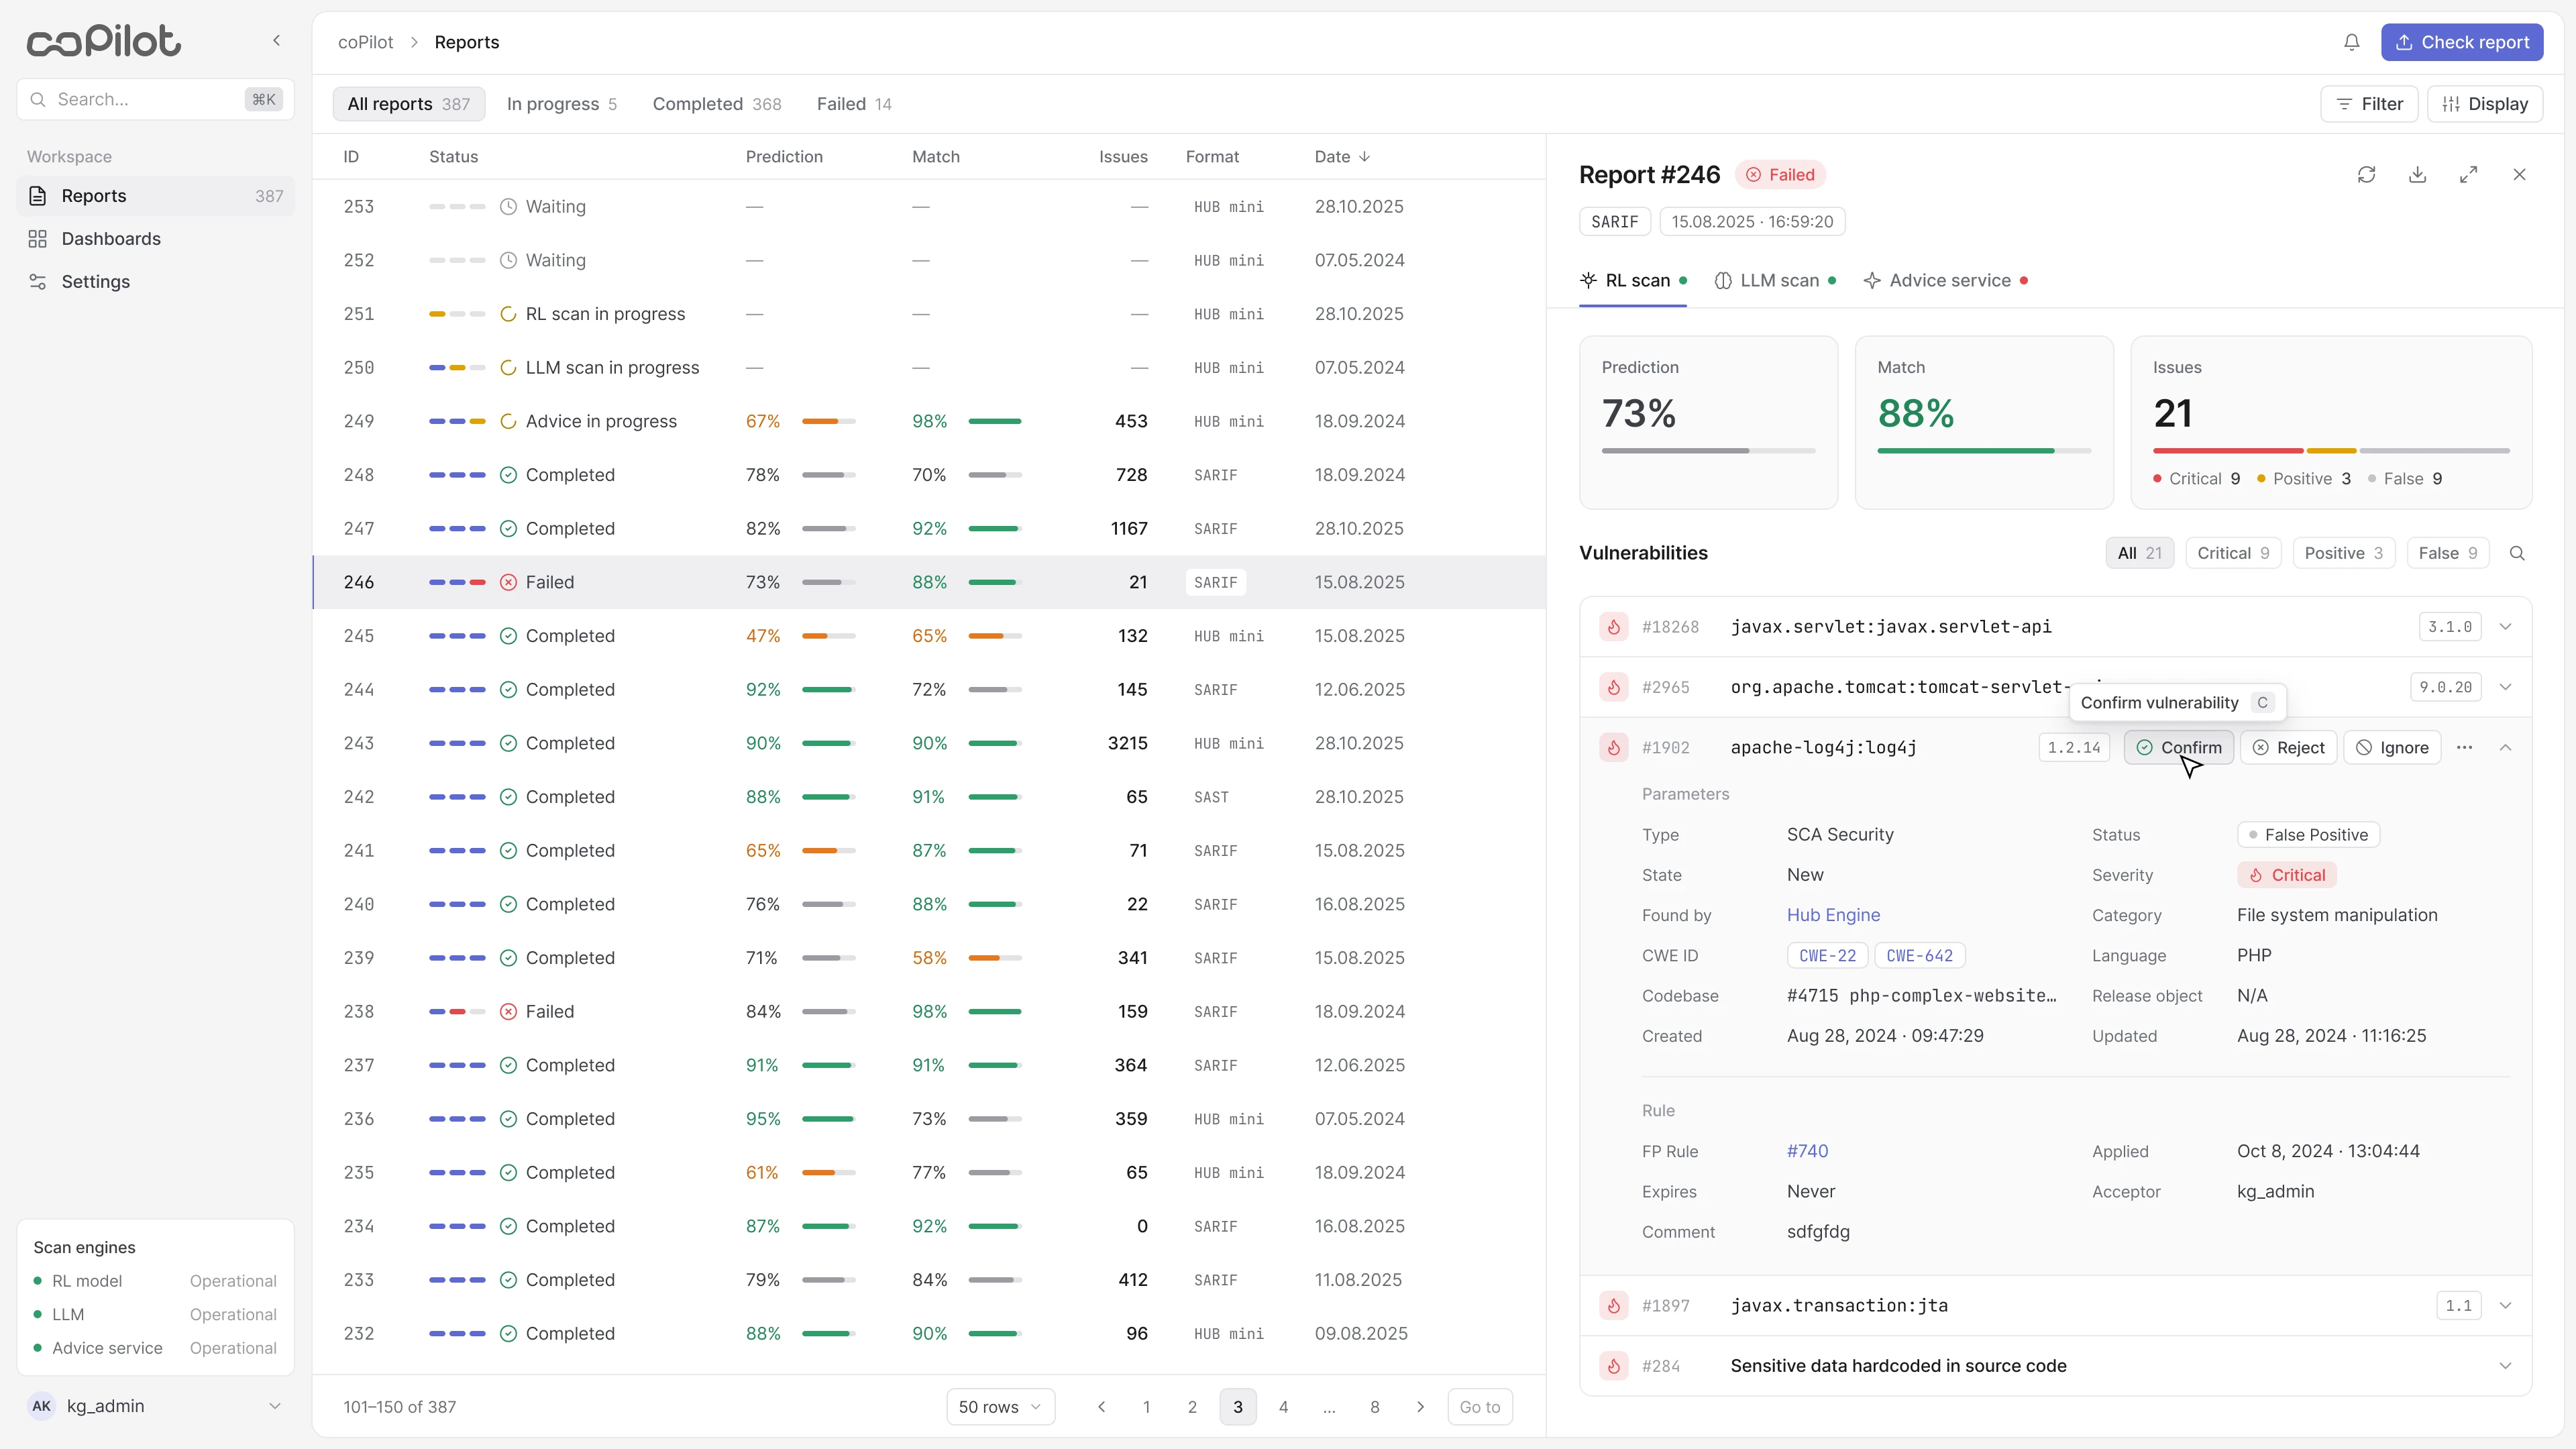
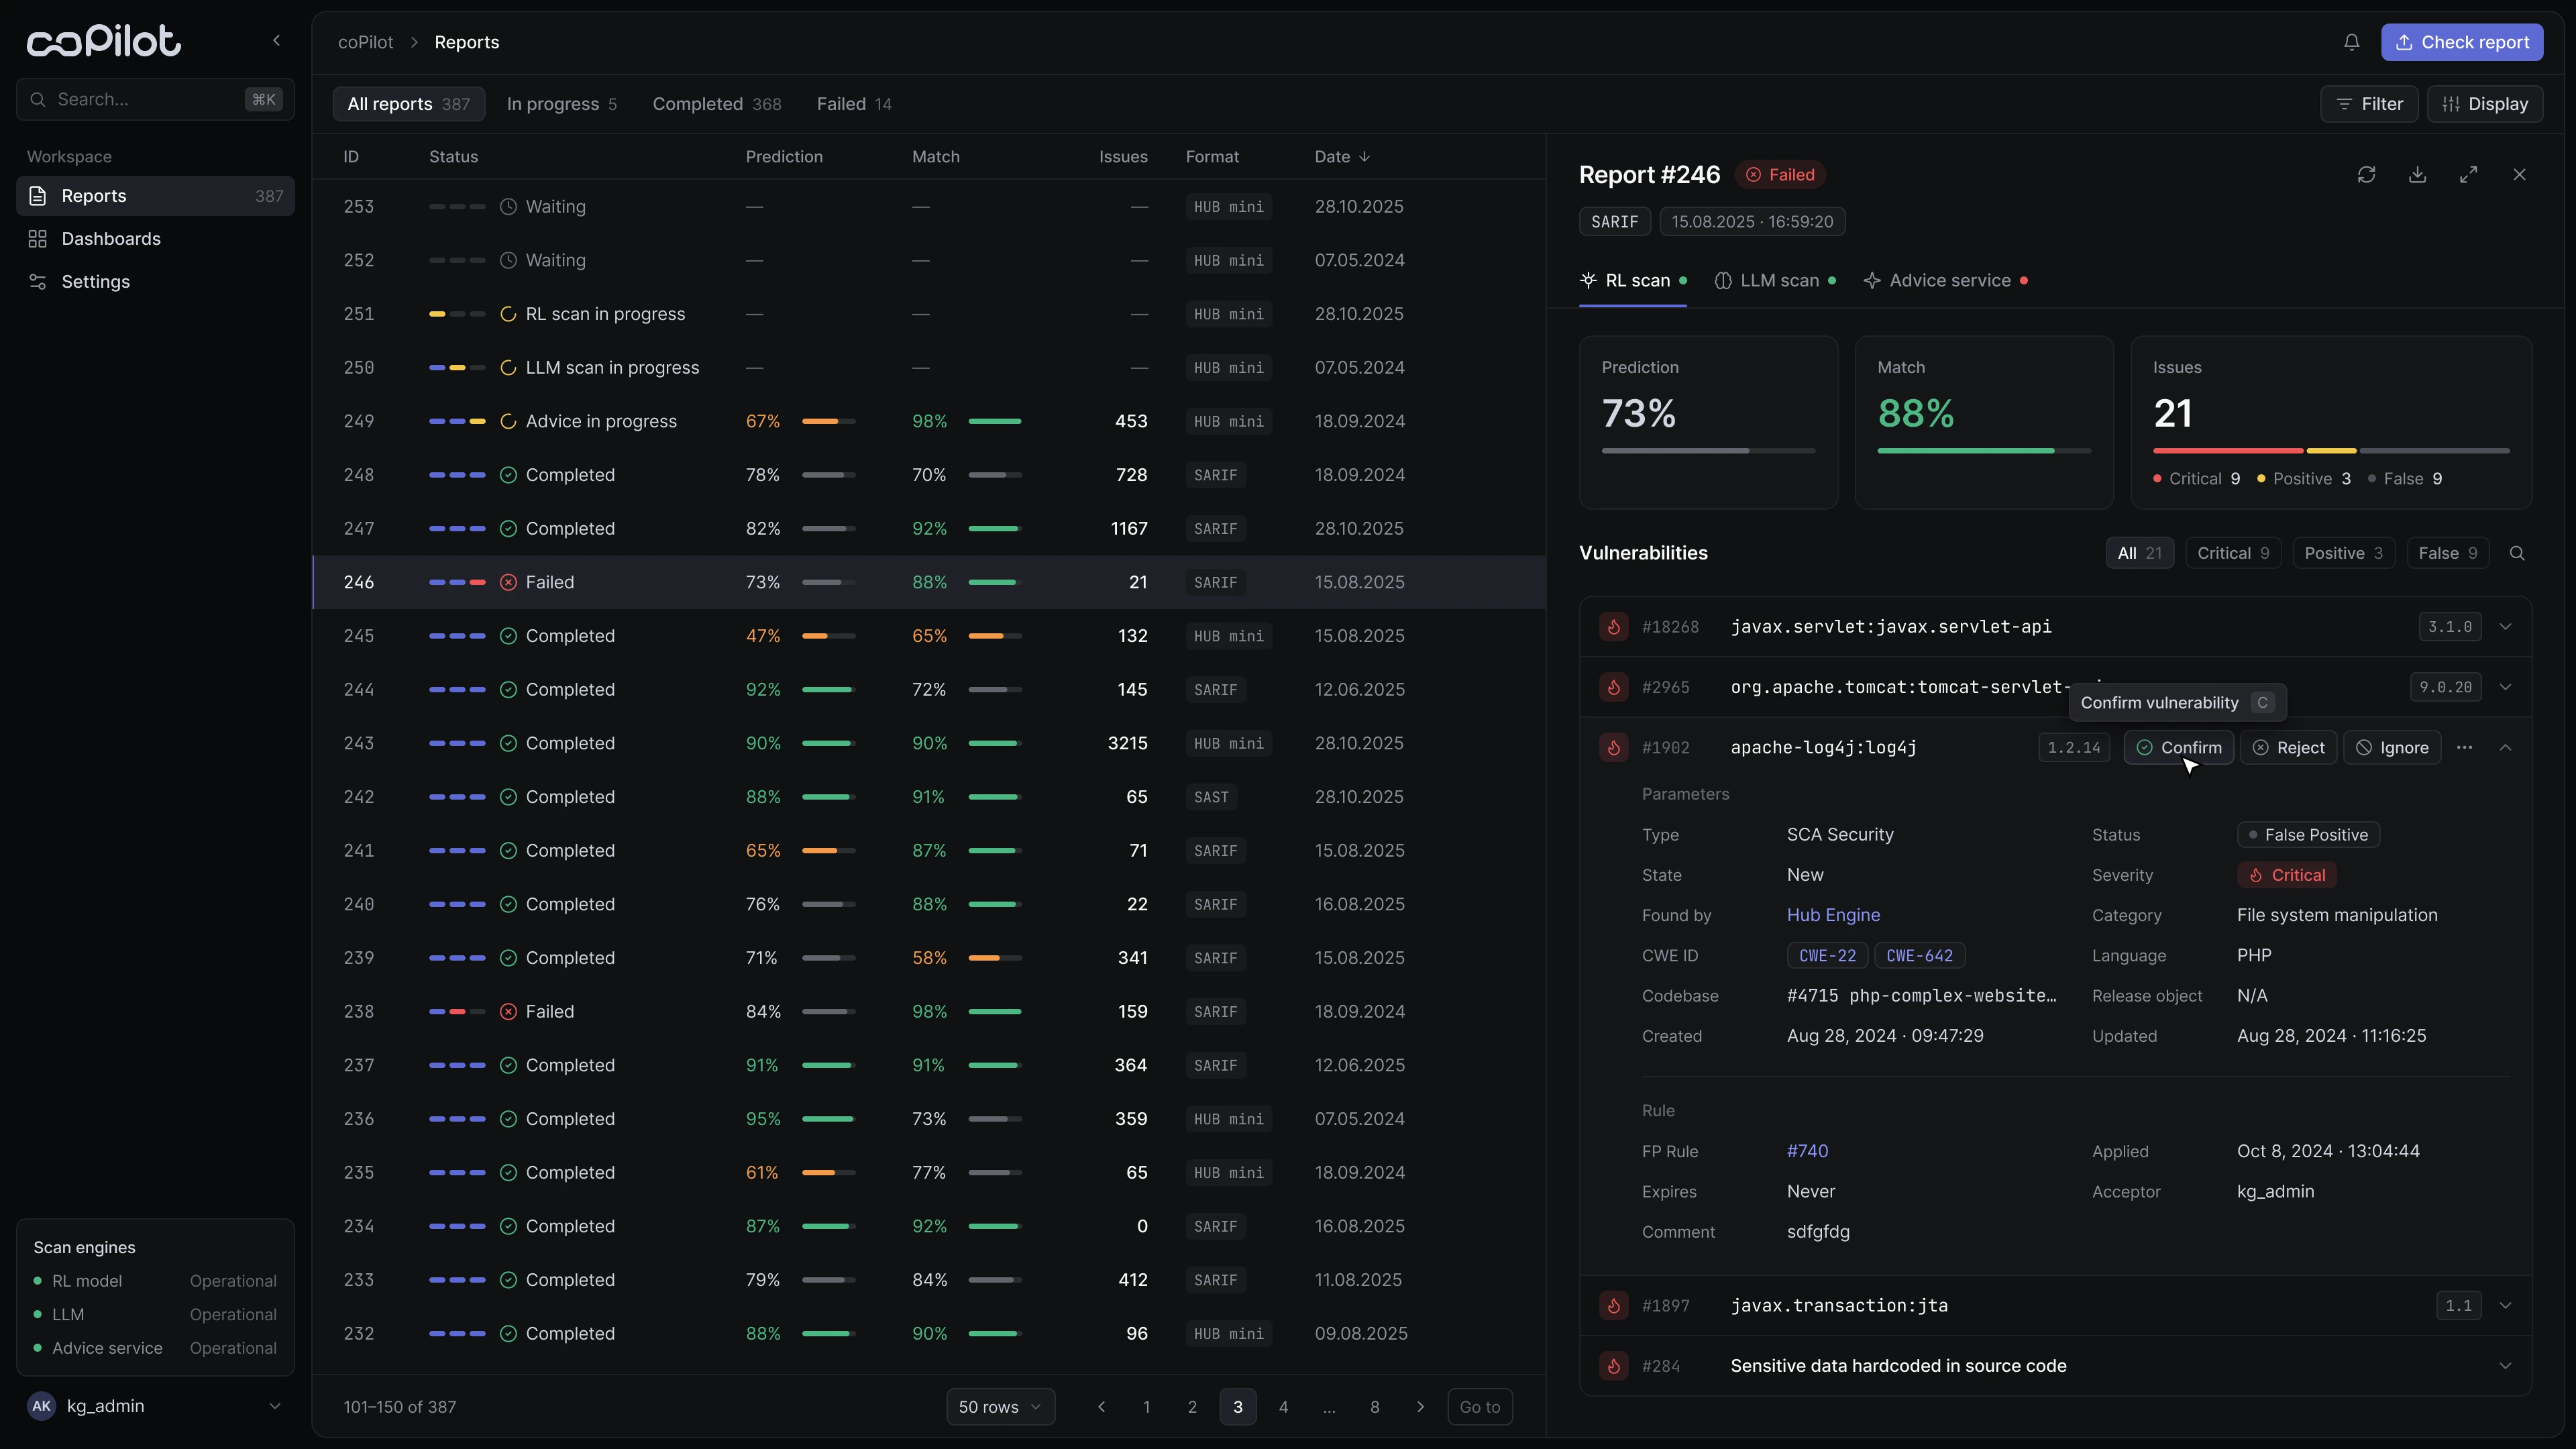
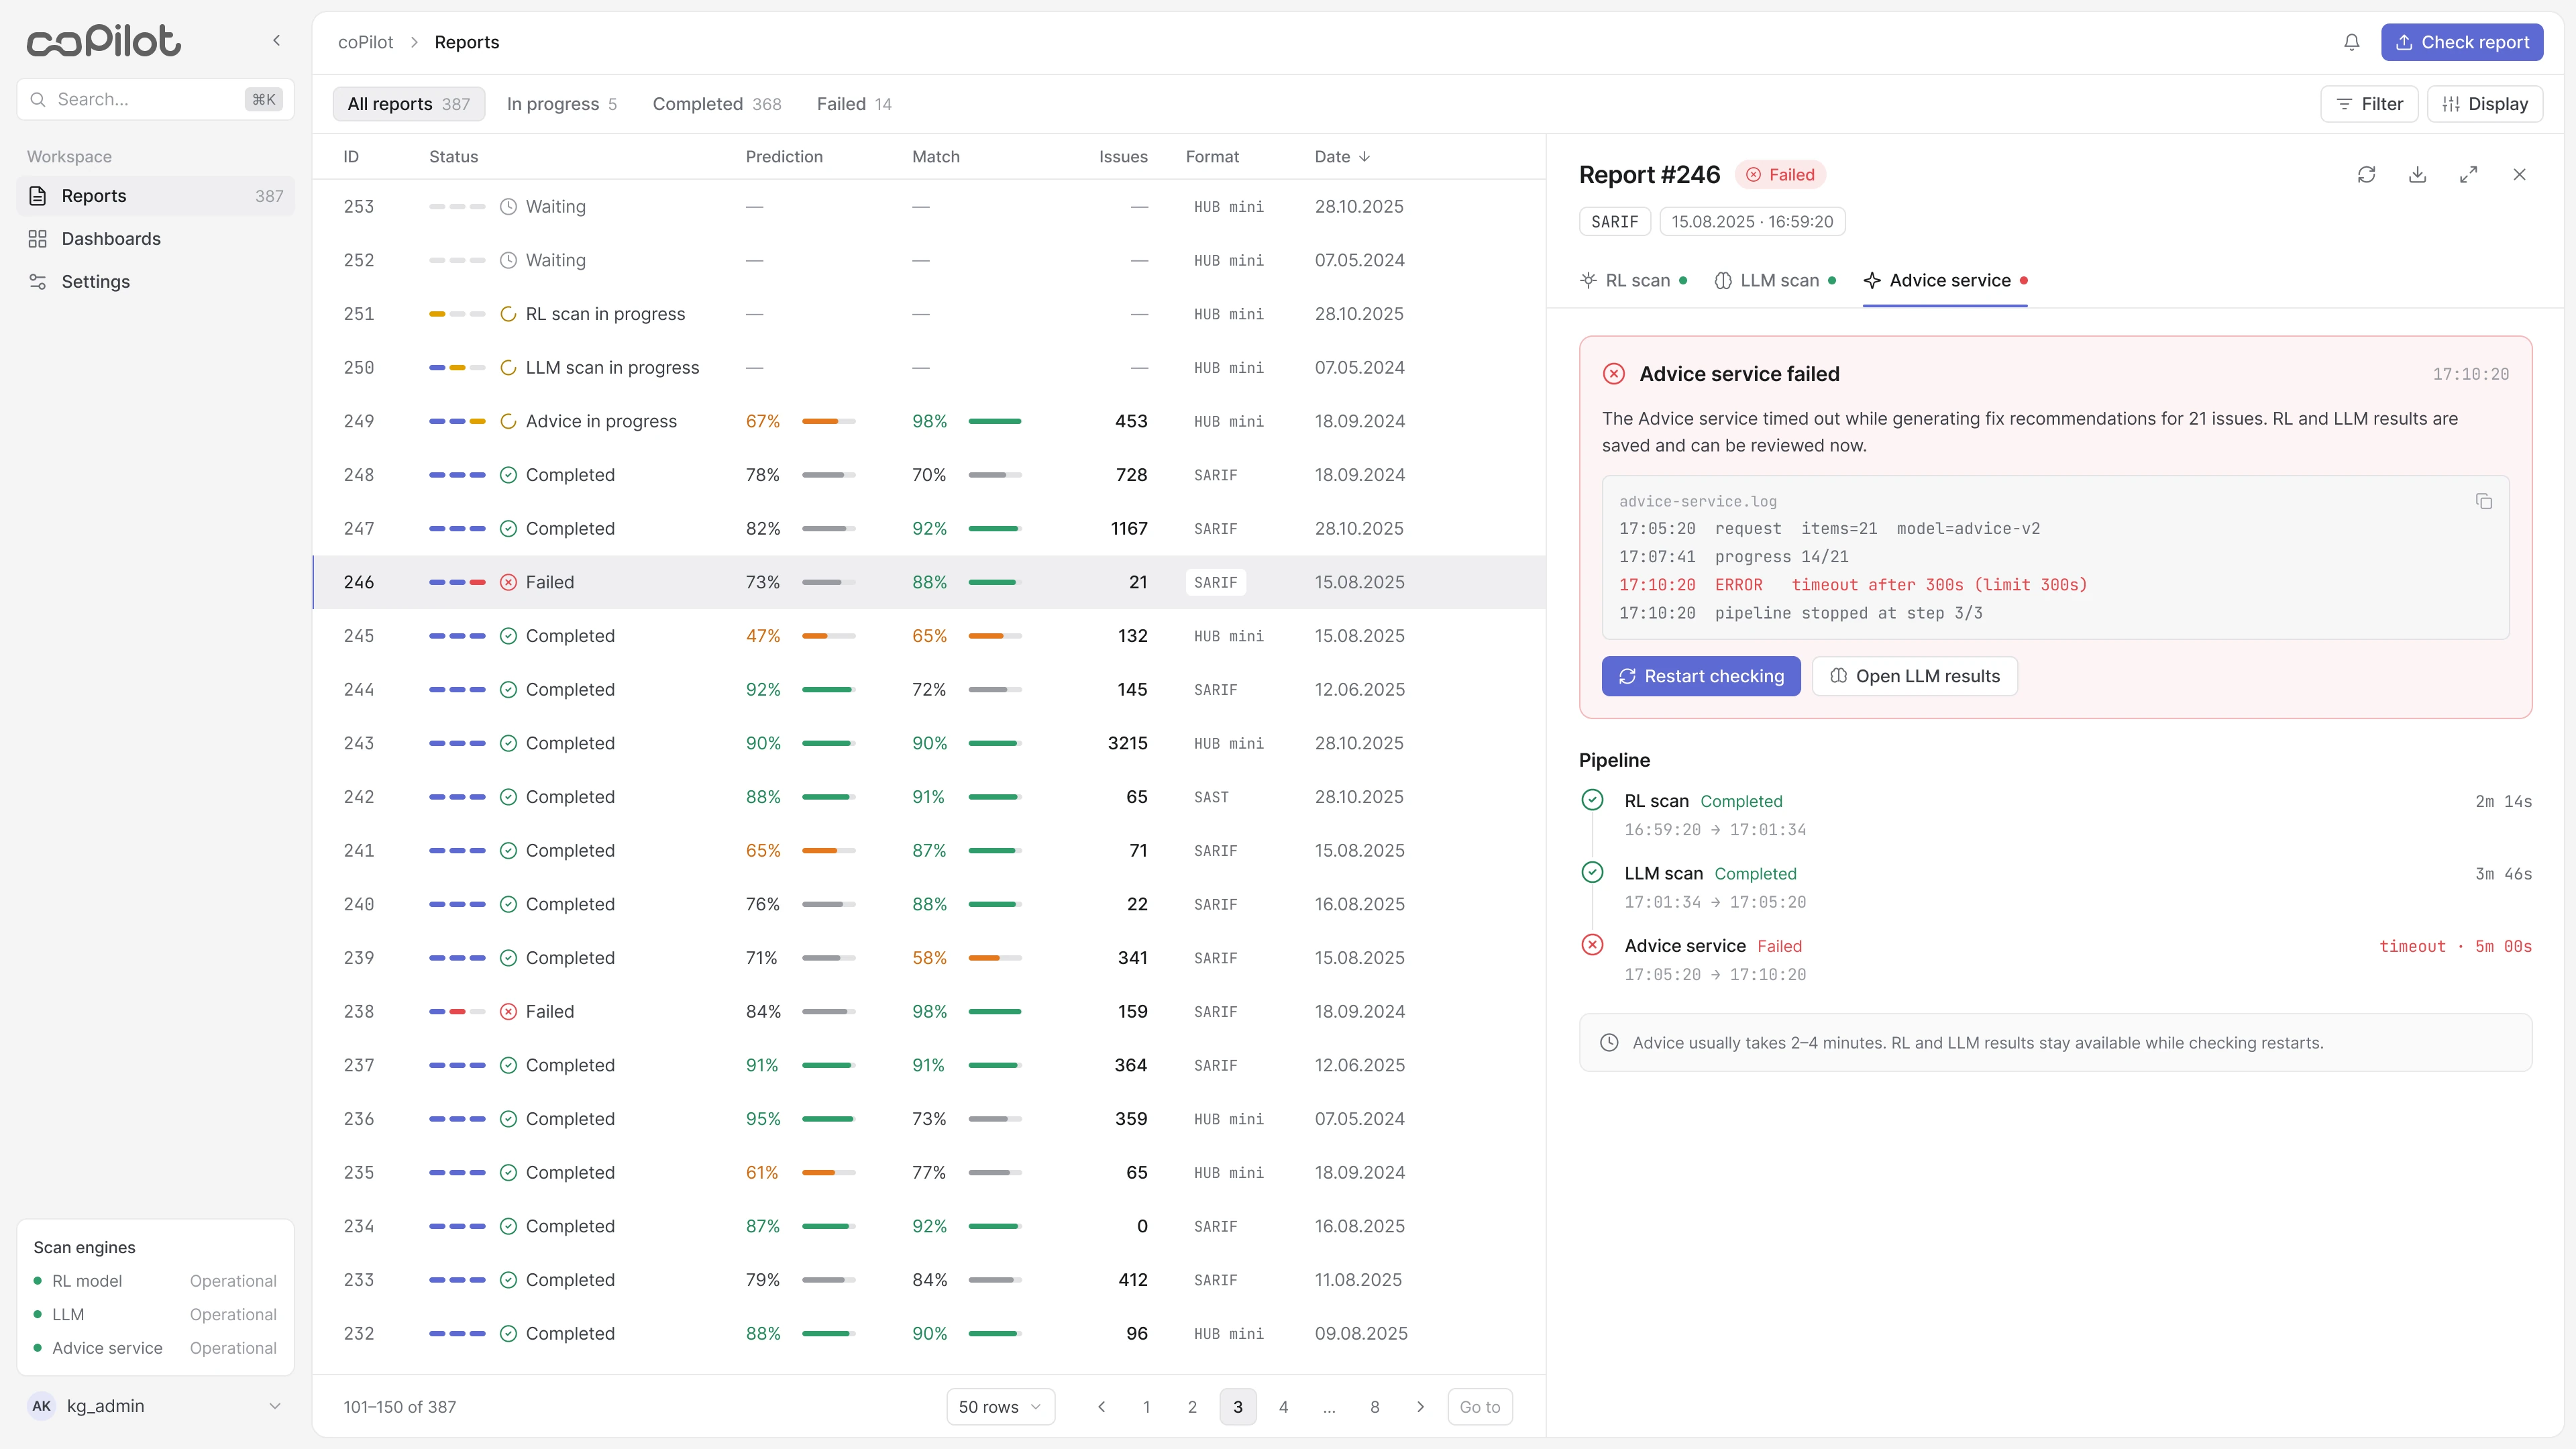
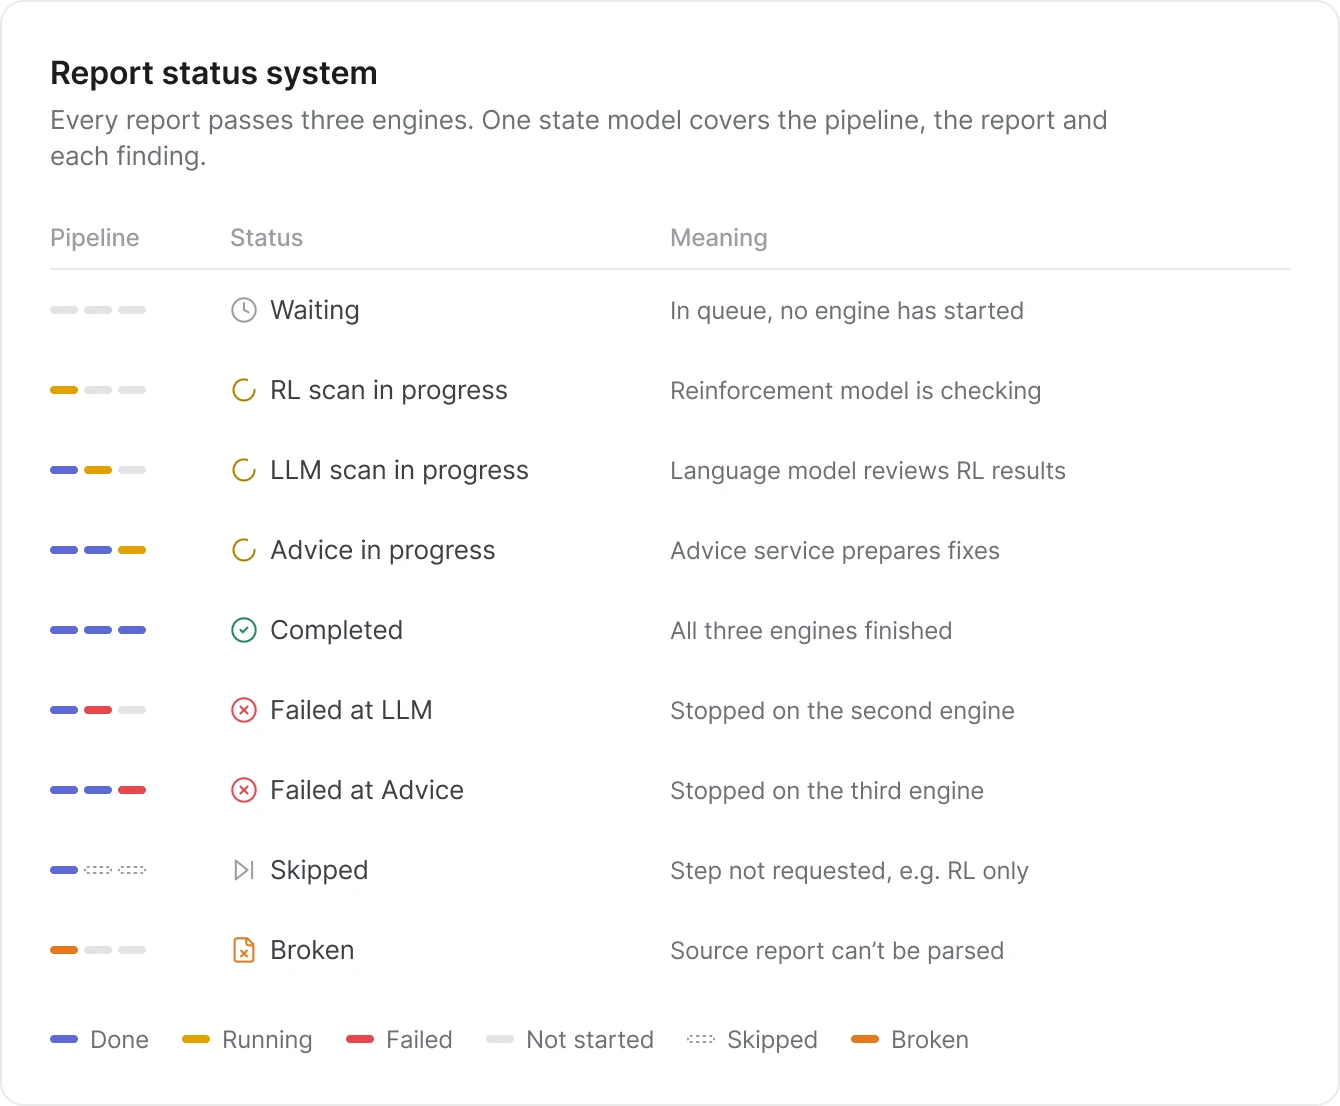
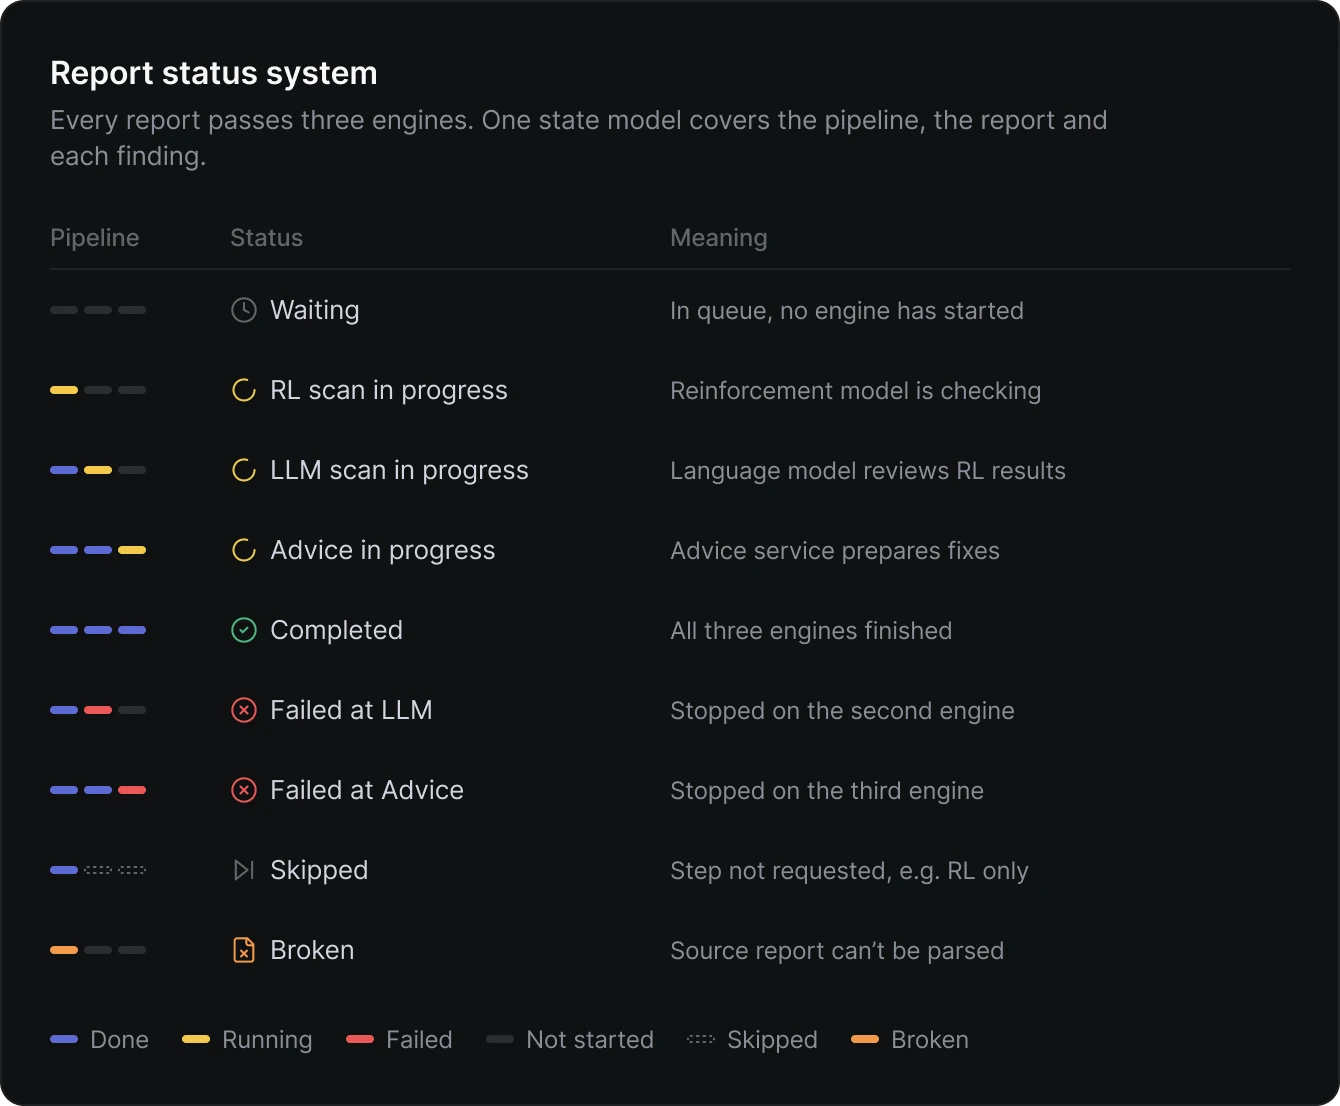
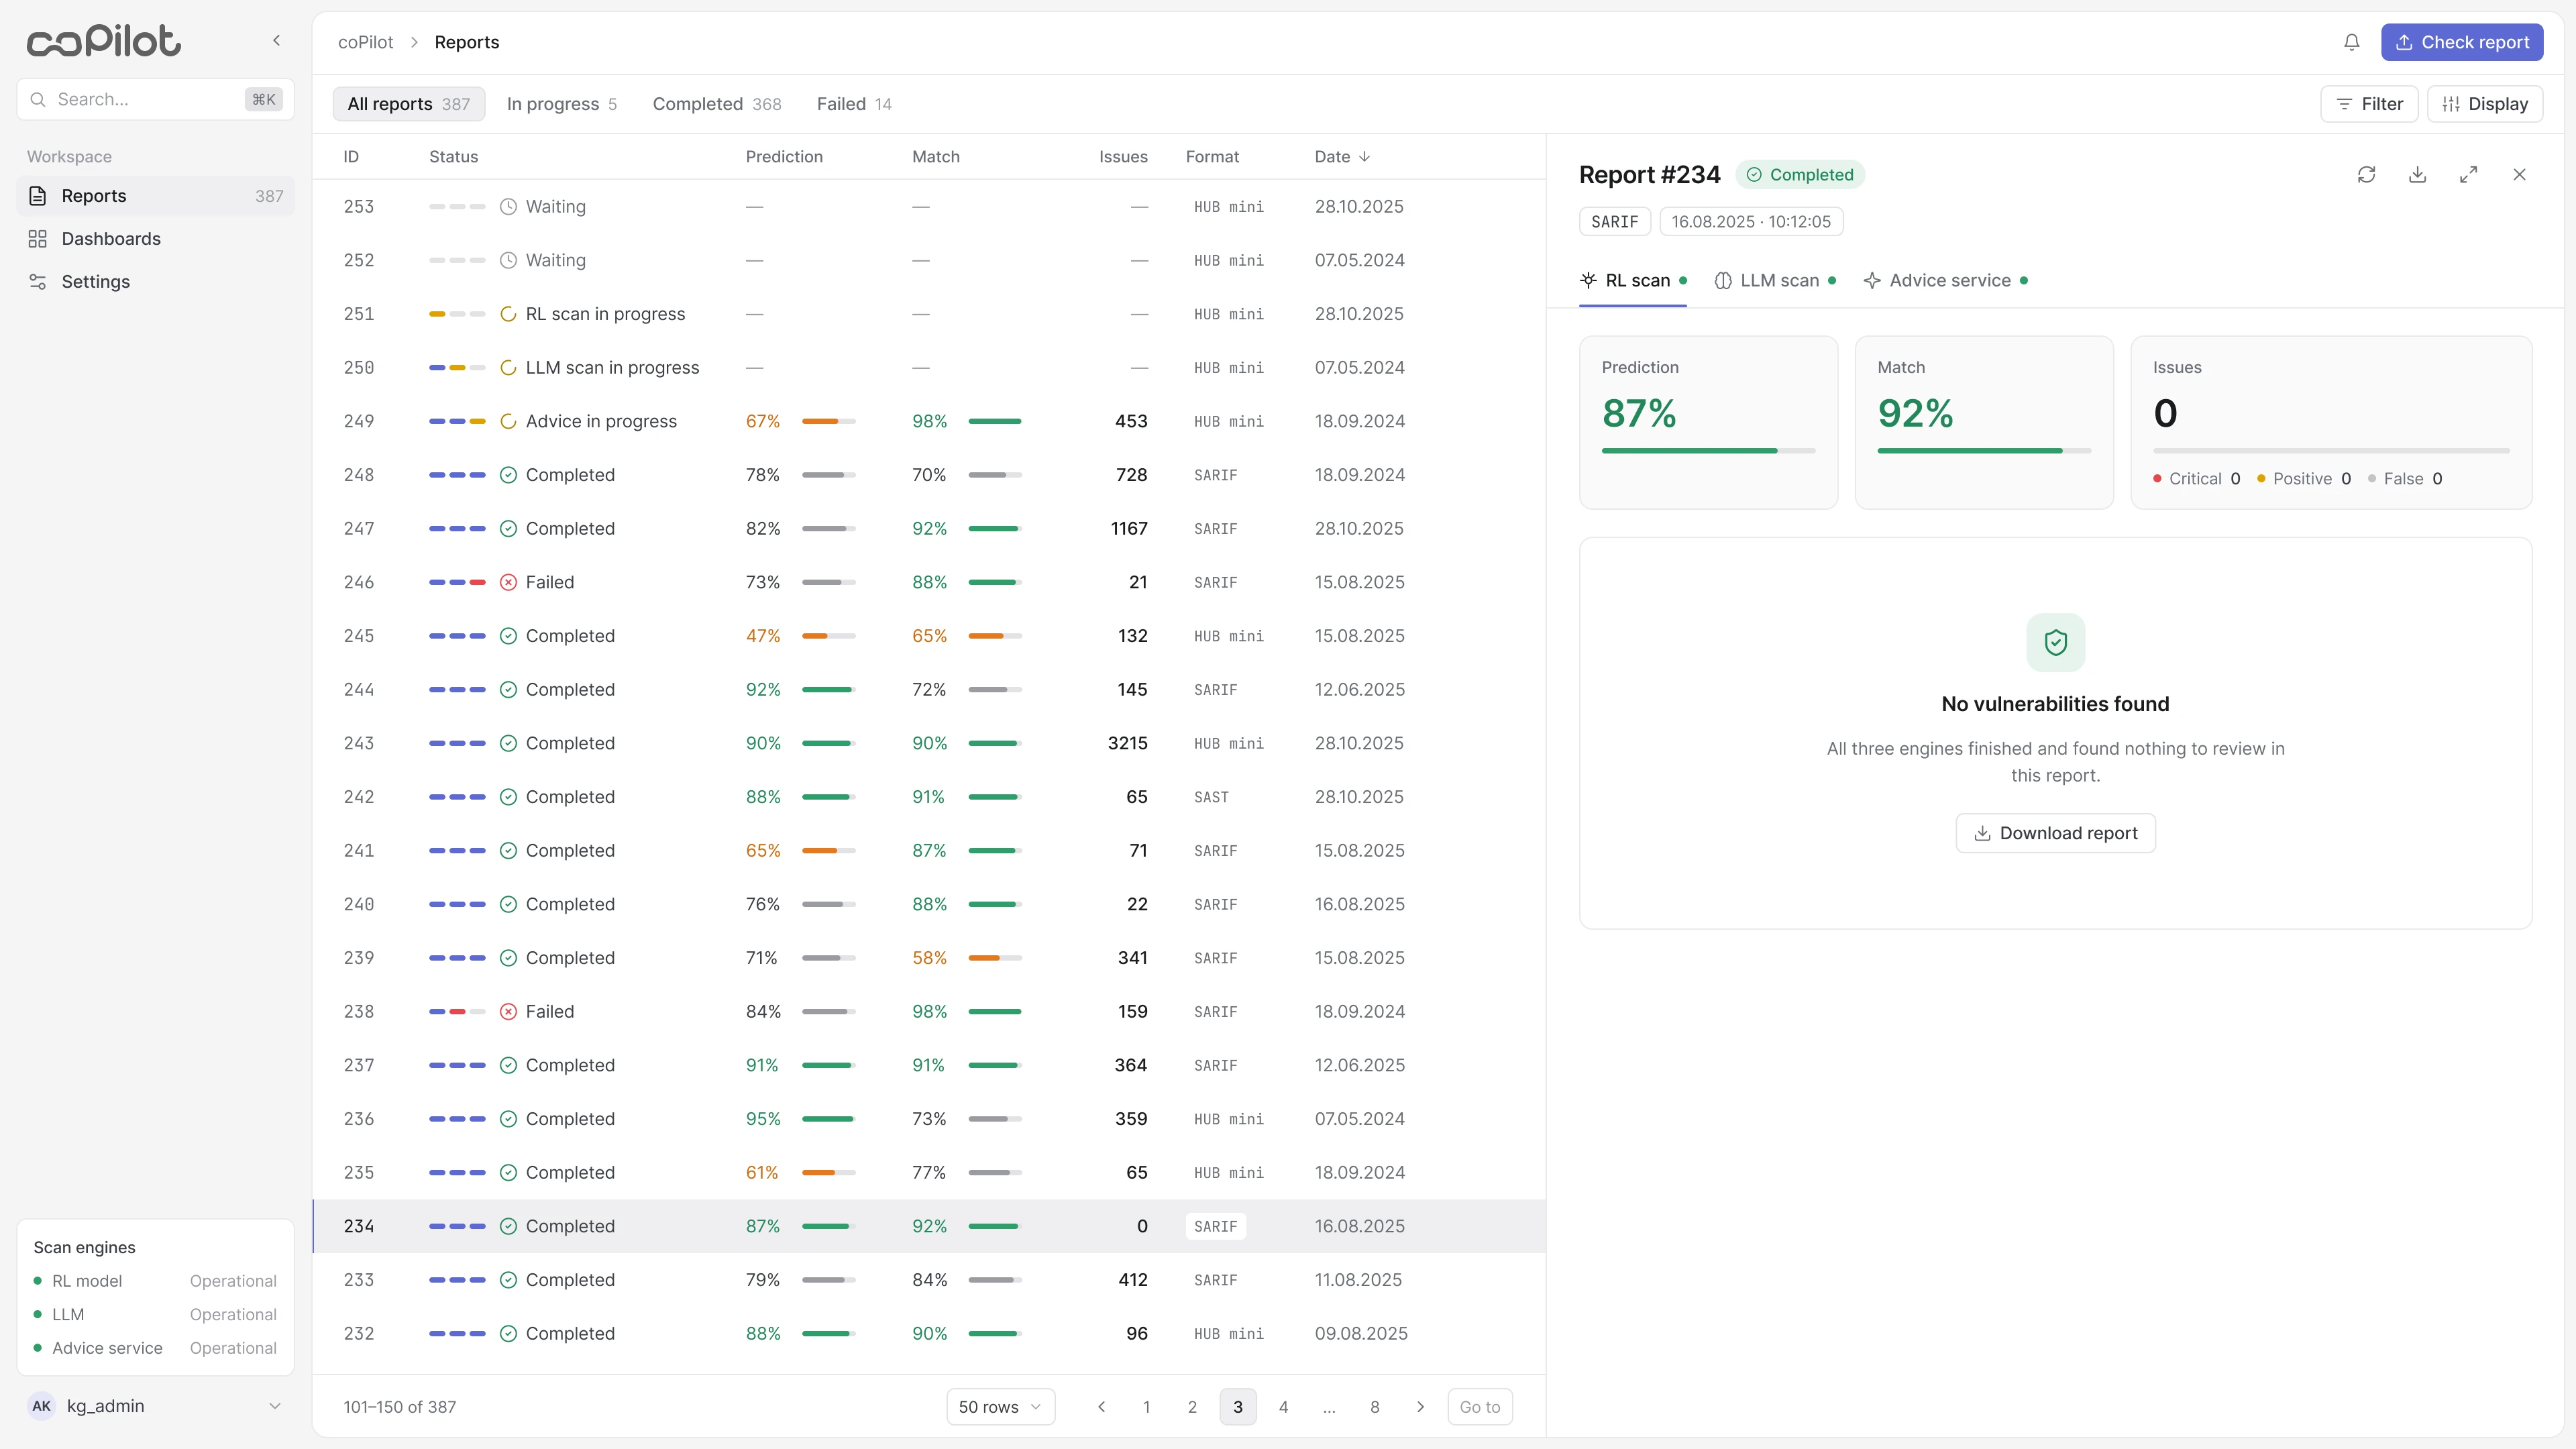
Вместо абстрактного прогресс-бара у каждого отчёта три сегмента — по одному на движок. С первого взгляда видно, где проверка сейчас, что уже готово и где она остановилась, и понятно, ждать или вмешаться.
Waiting · In progress · Completed · Skipped · Failed · Broken
03От итога к разбору находки
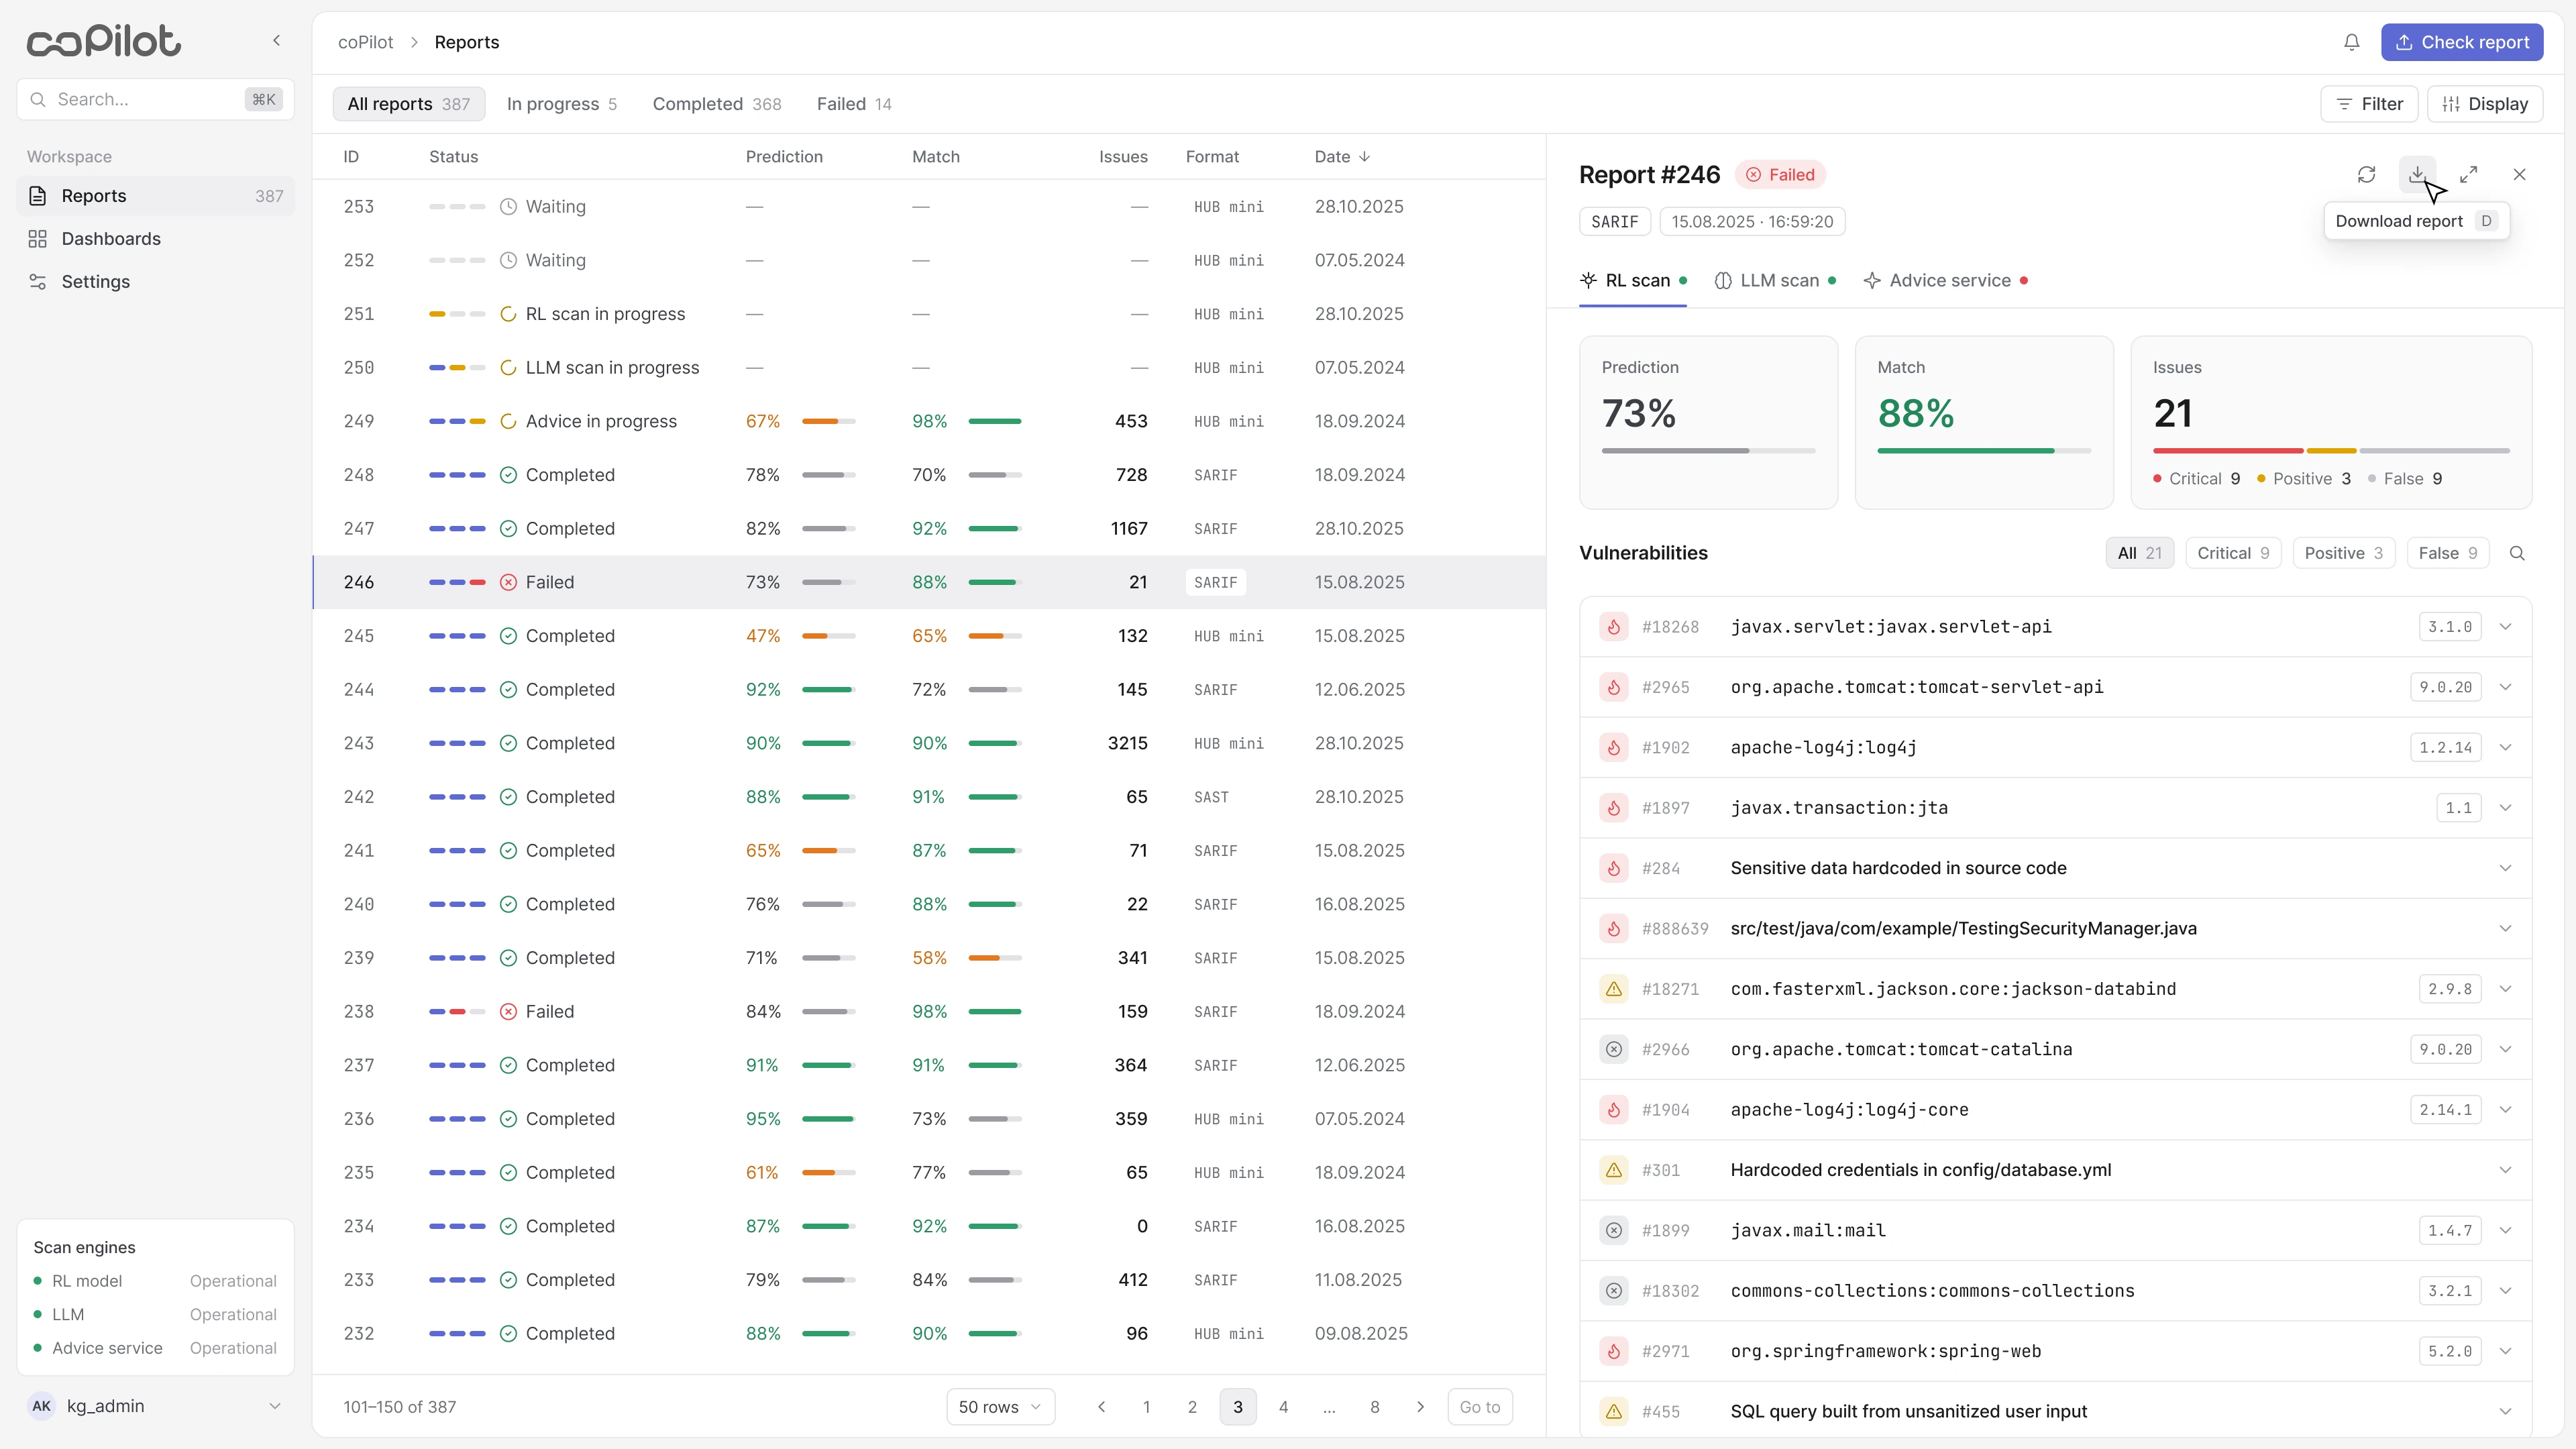
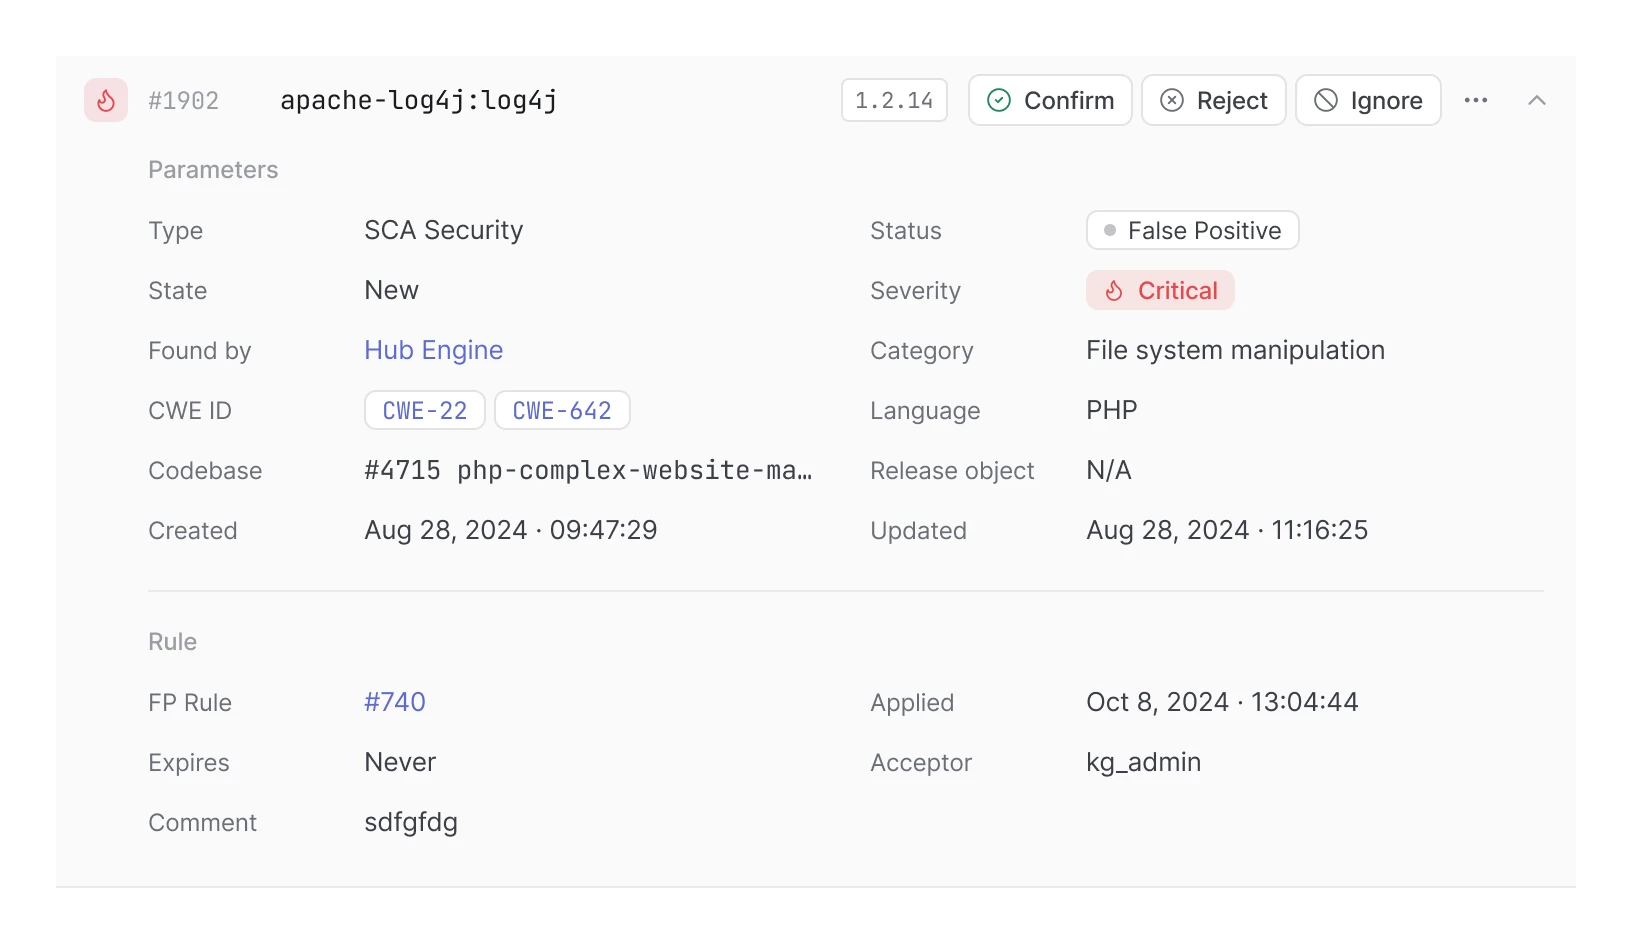
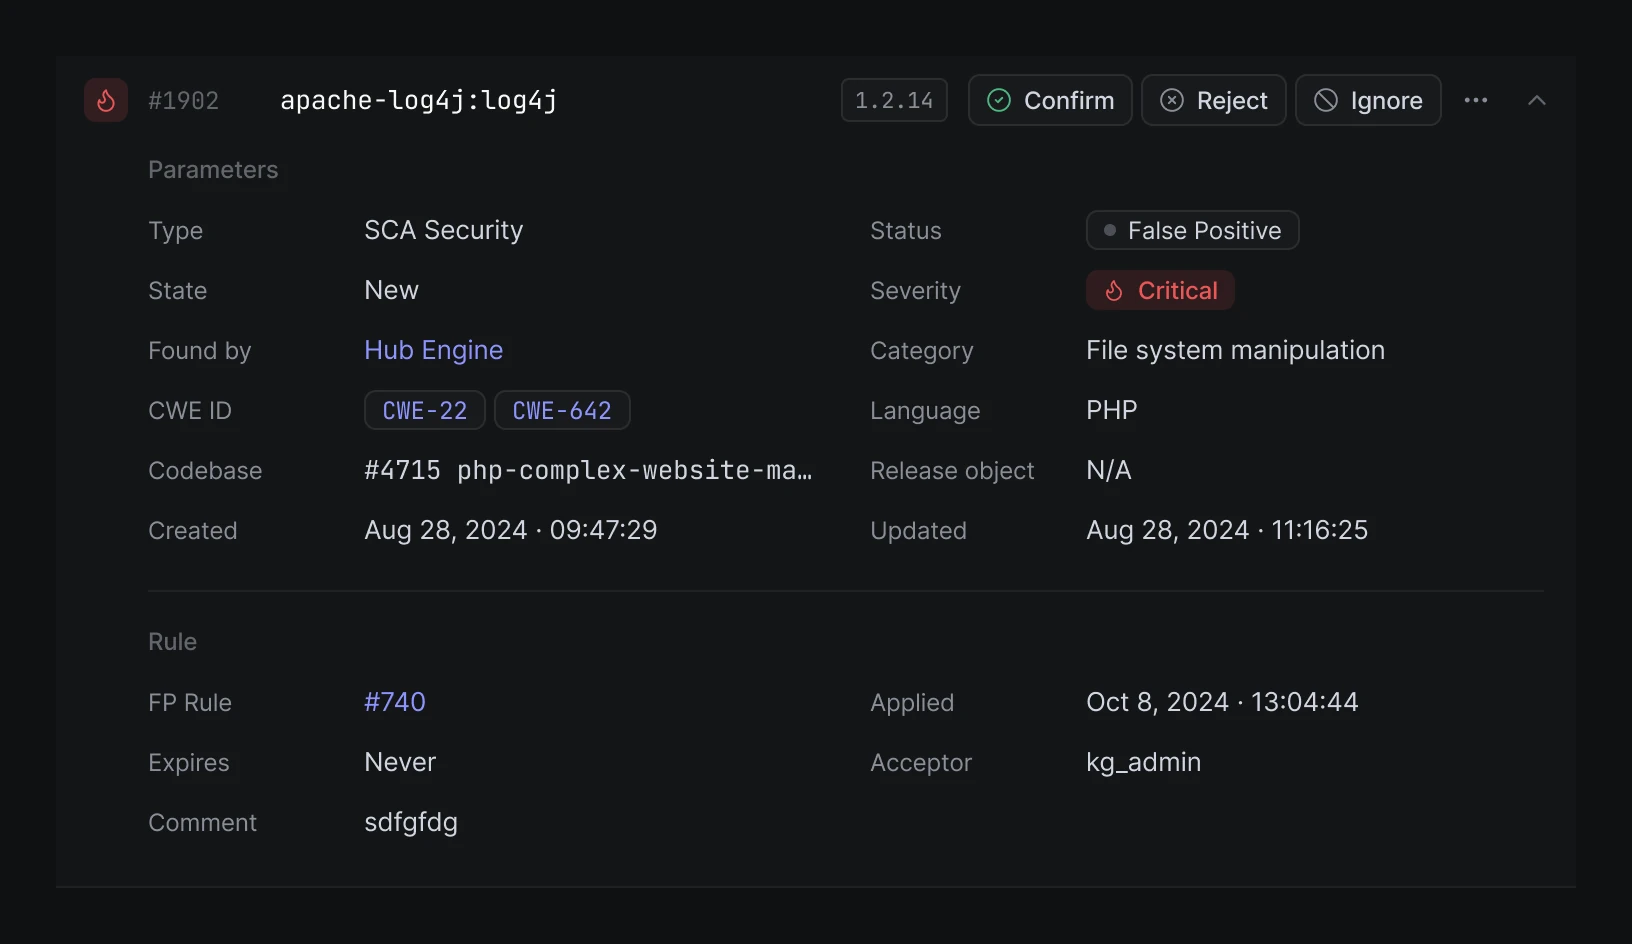
Отчёт открывается рядом со списком, поэтому аналитик не теряет контекст. В панели у информации чёткая иерархия:
- итог проверки: Prediction, Match и число находок по типам
- находка и её технические параметры
- статус проверки и правило, по которому принято решение
- следующее действие эксперта
04Последнее слово за человеком
Подтвердить, отклонить или игнорировать находку может только эксперт, и каждое решение сохраняется в истории. Действия подписаны словами, а не спрятаны в иконки: в решении, которое потом защищают на аудите, не должно быть угадывания.
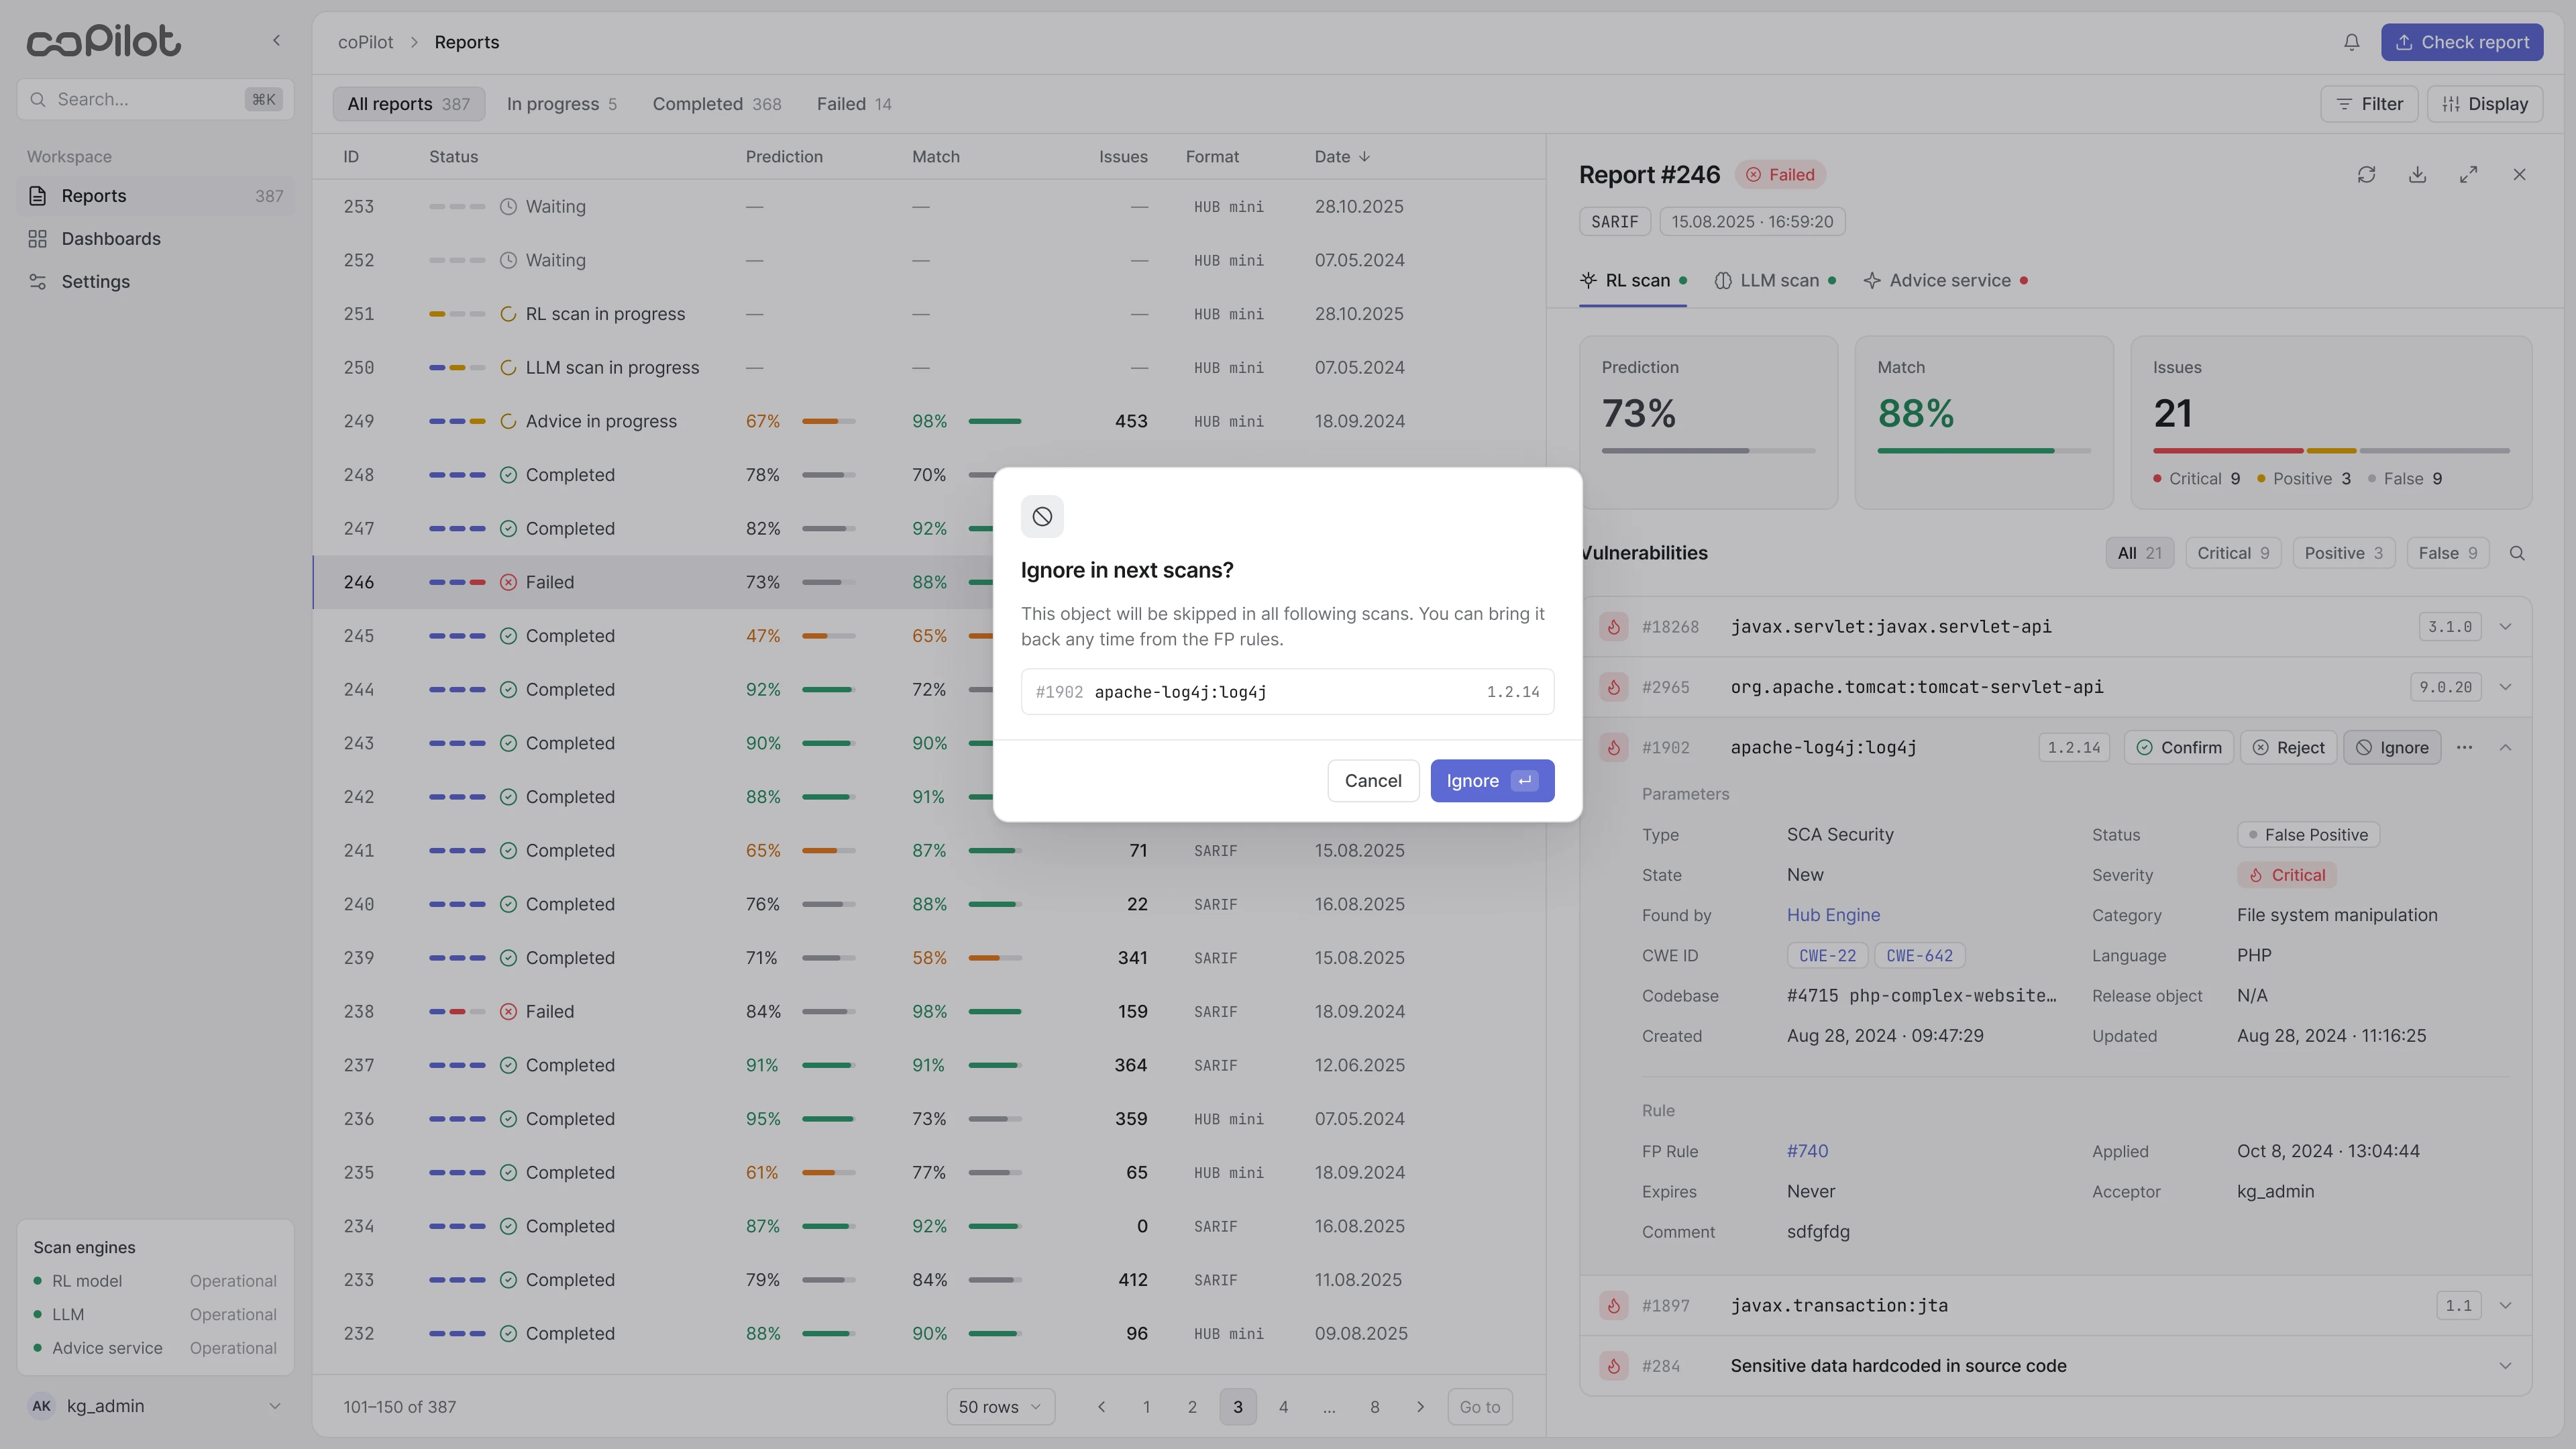
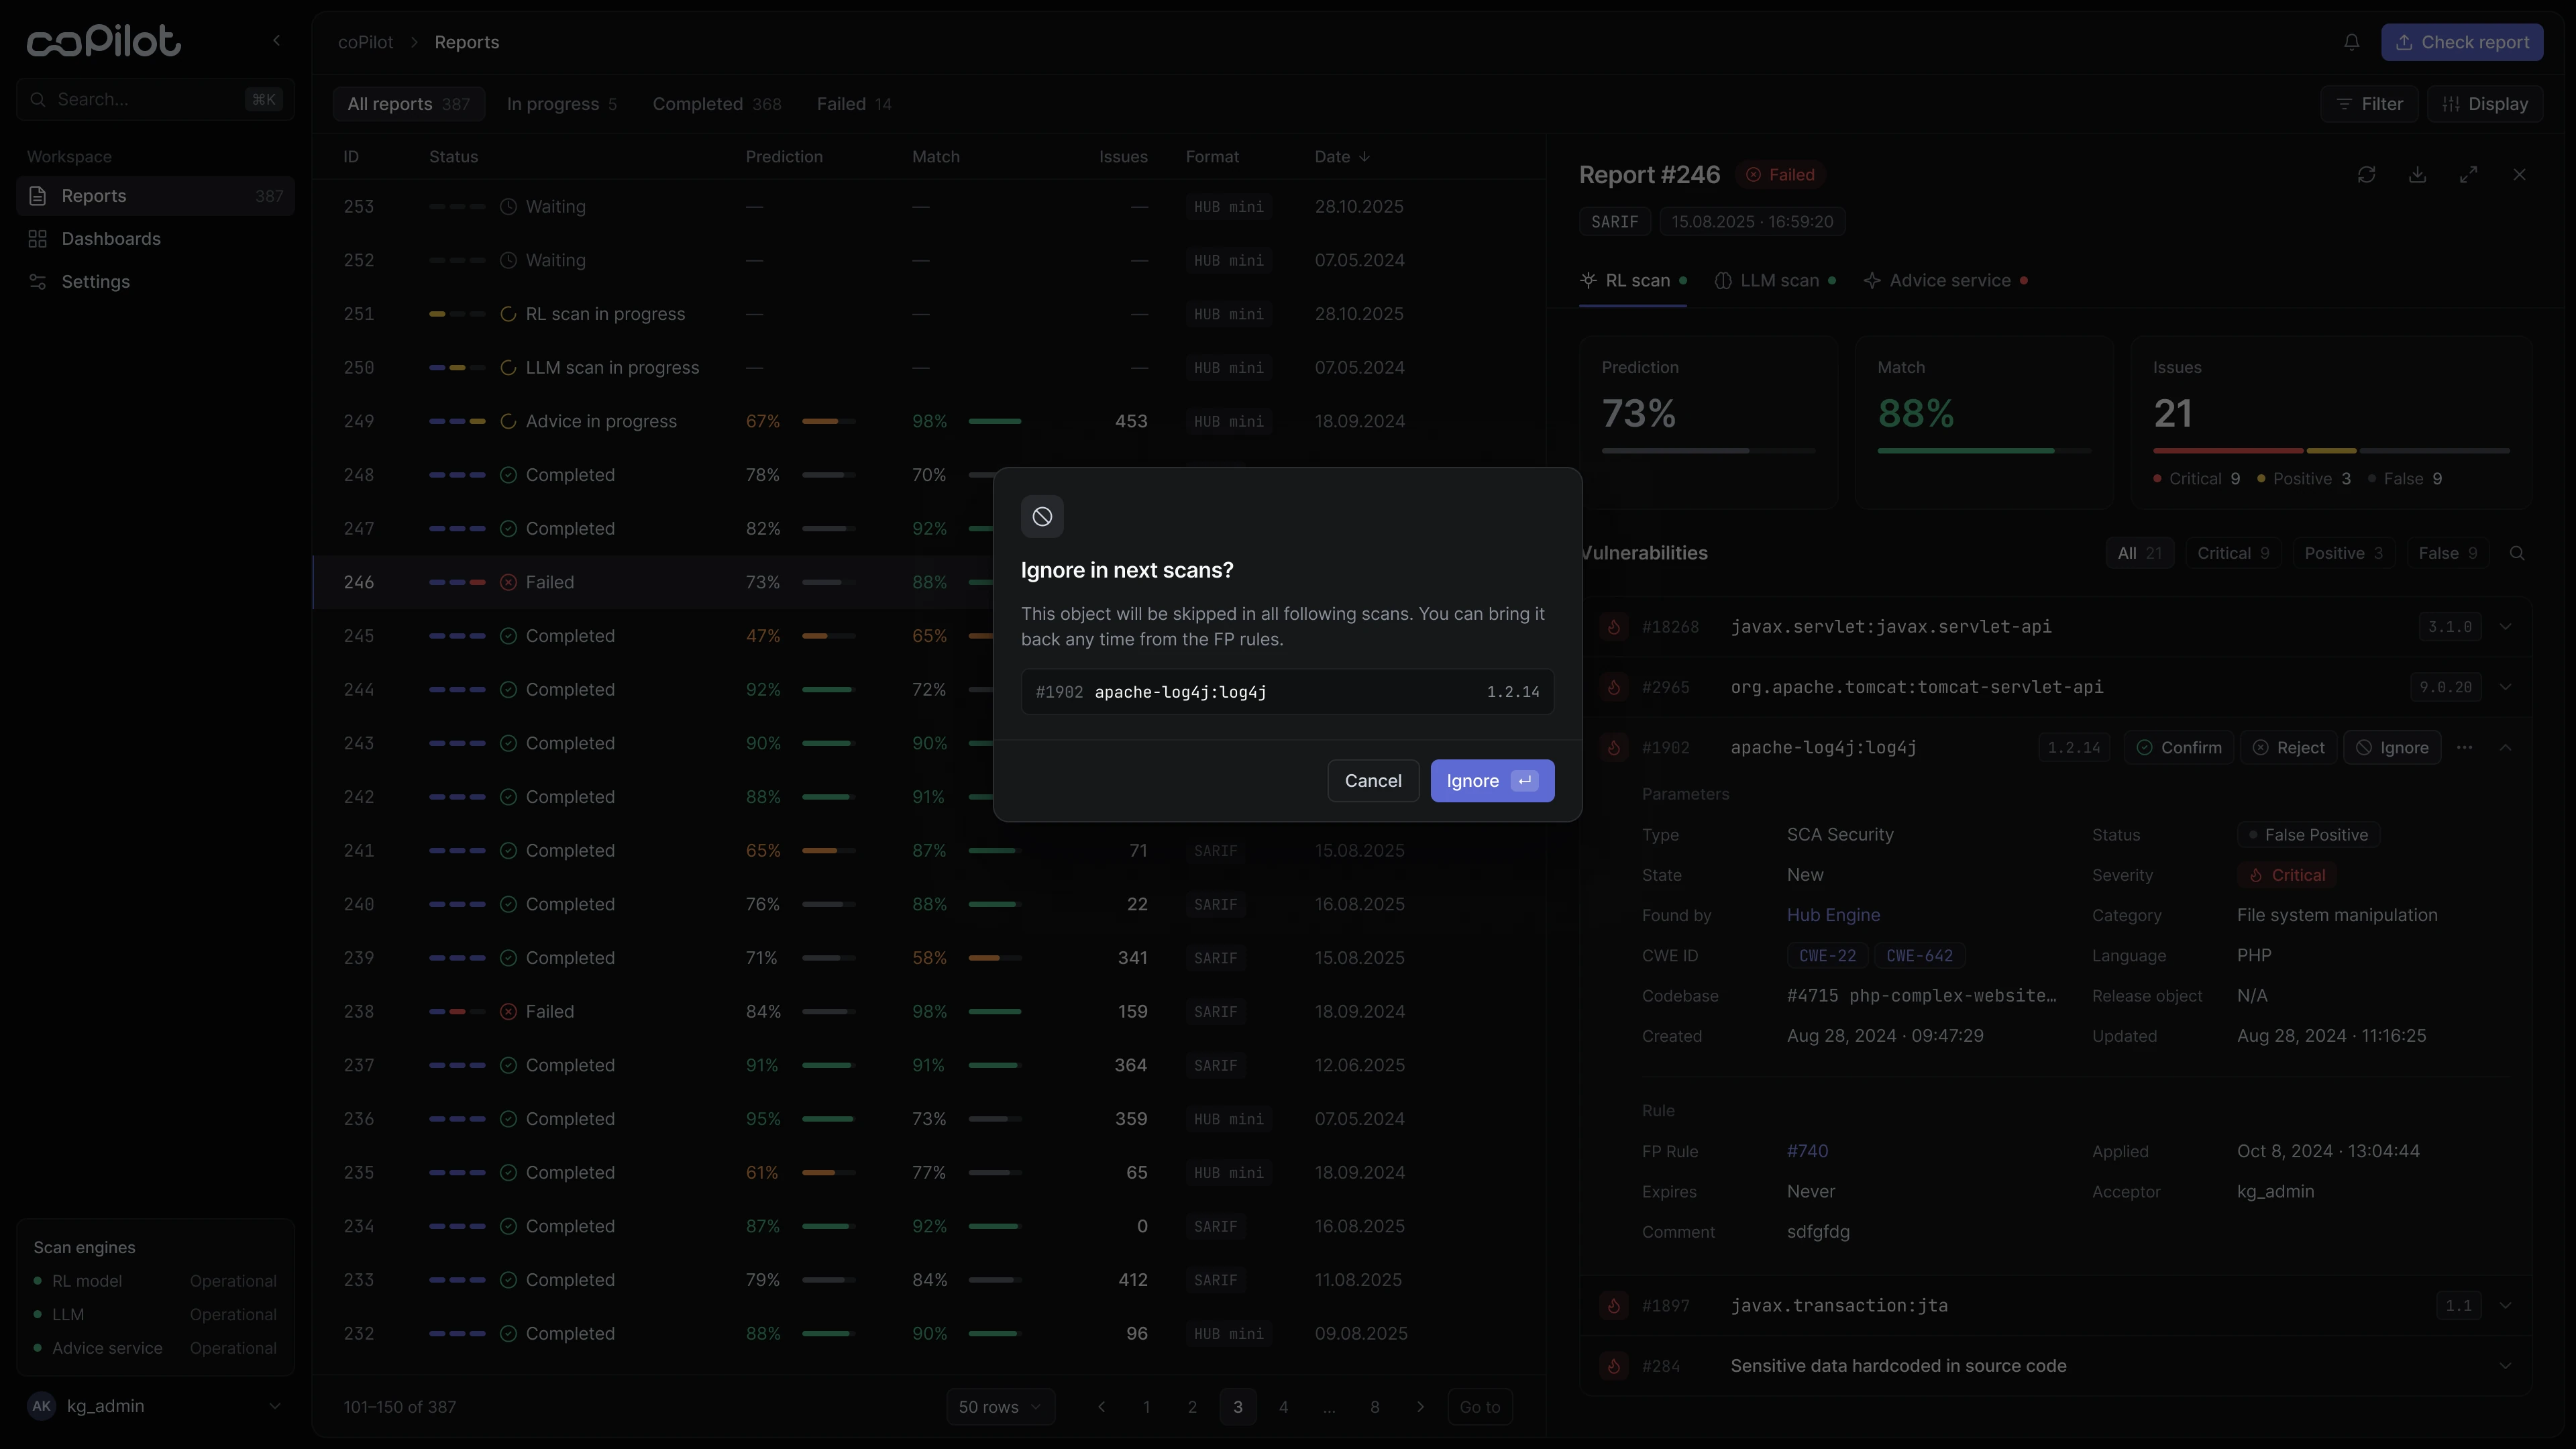
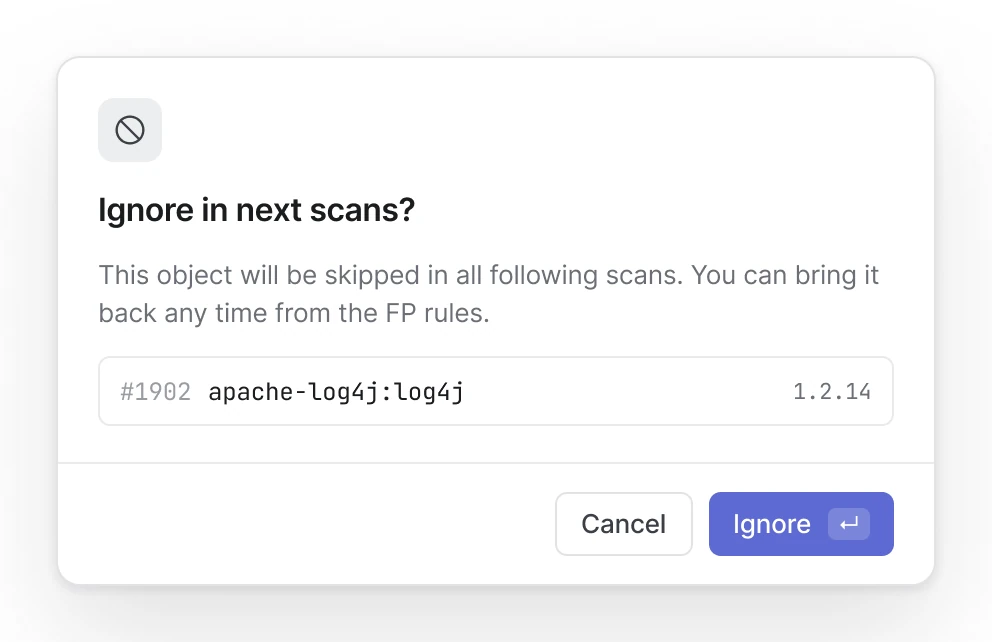
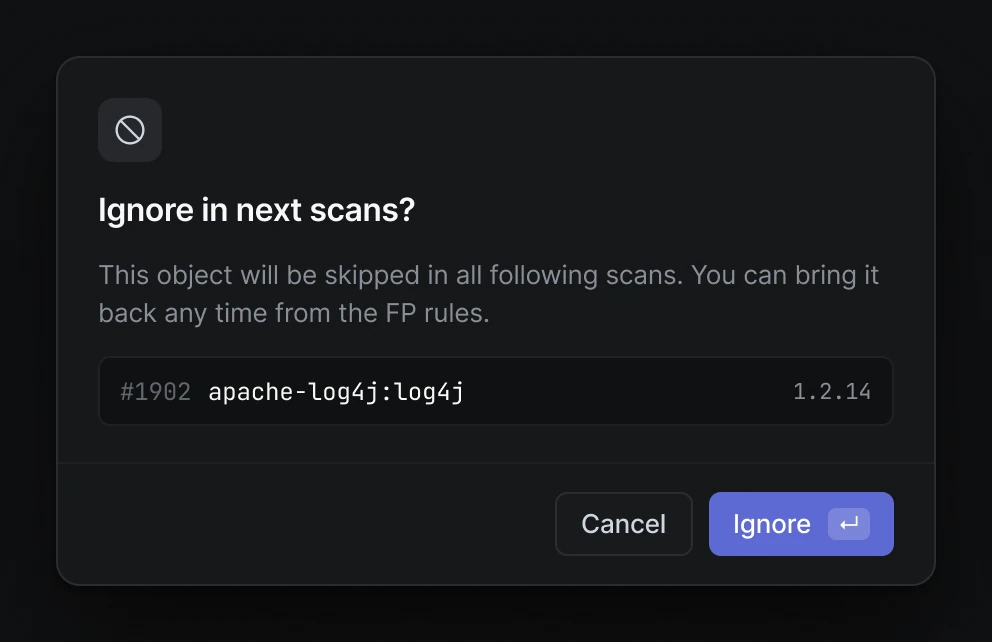
05Действия с последствиями для будущих сканов
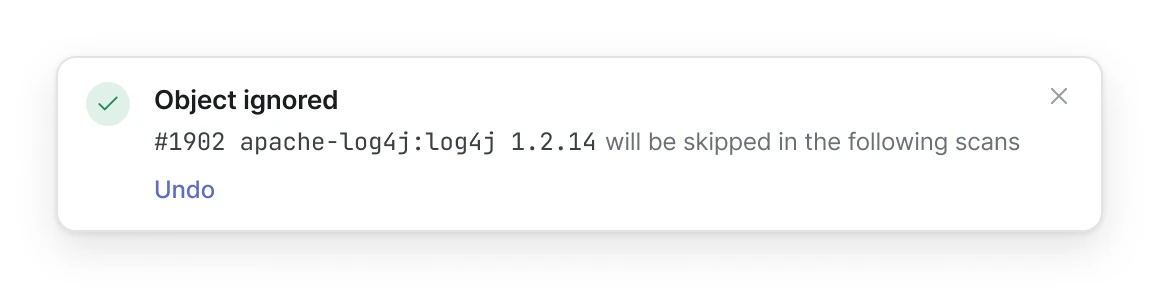
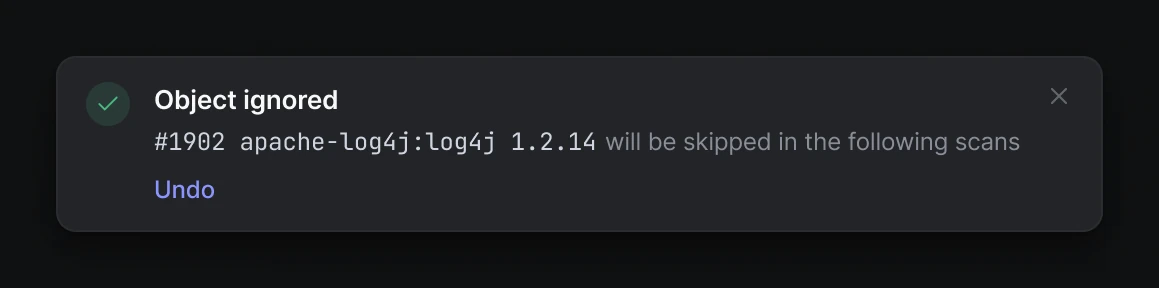
«Игнорировать» исключает объект из следующих сканов, поэтому это не просто «скрыть»: последствие показано до подтверждения, а после действия система сообщает, что правило применится дальше.
06Сбой — это не тупик
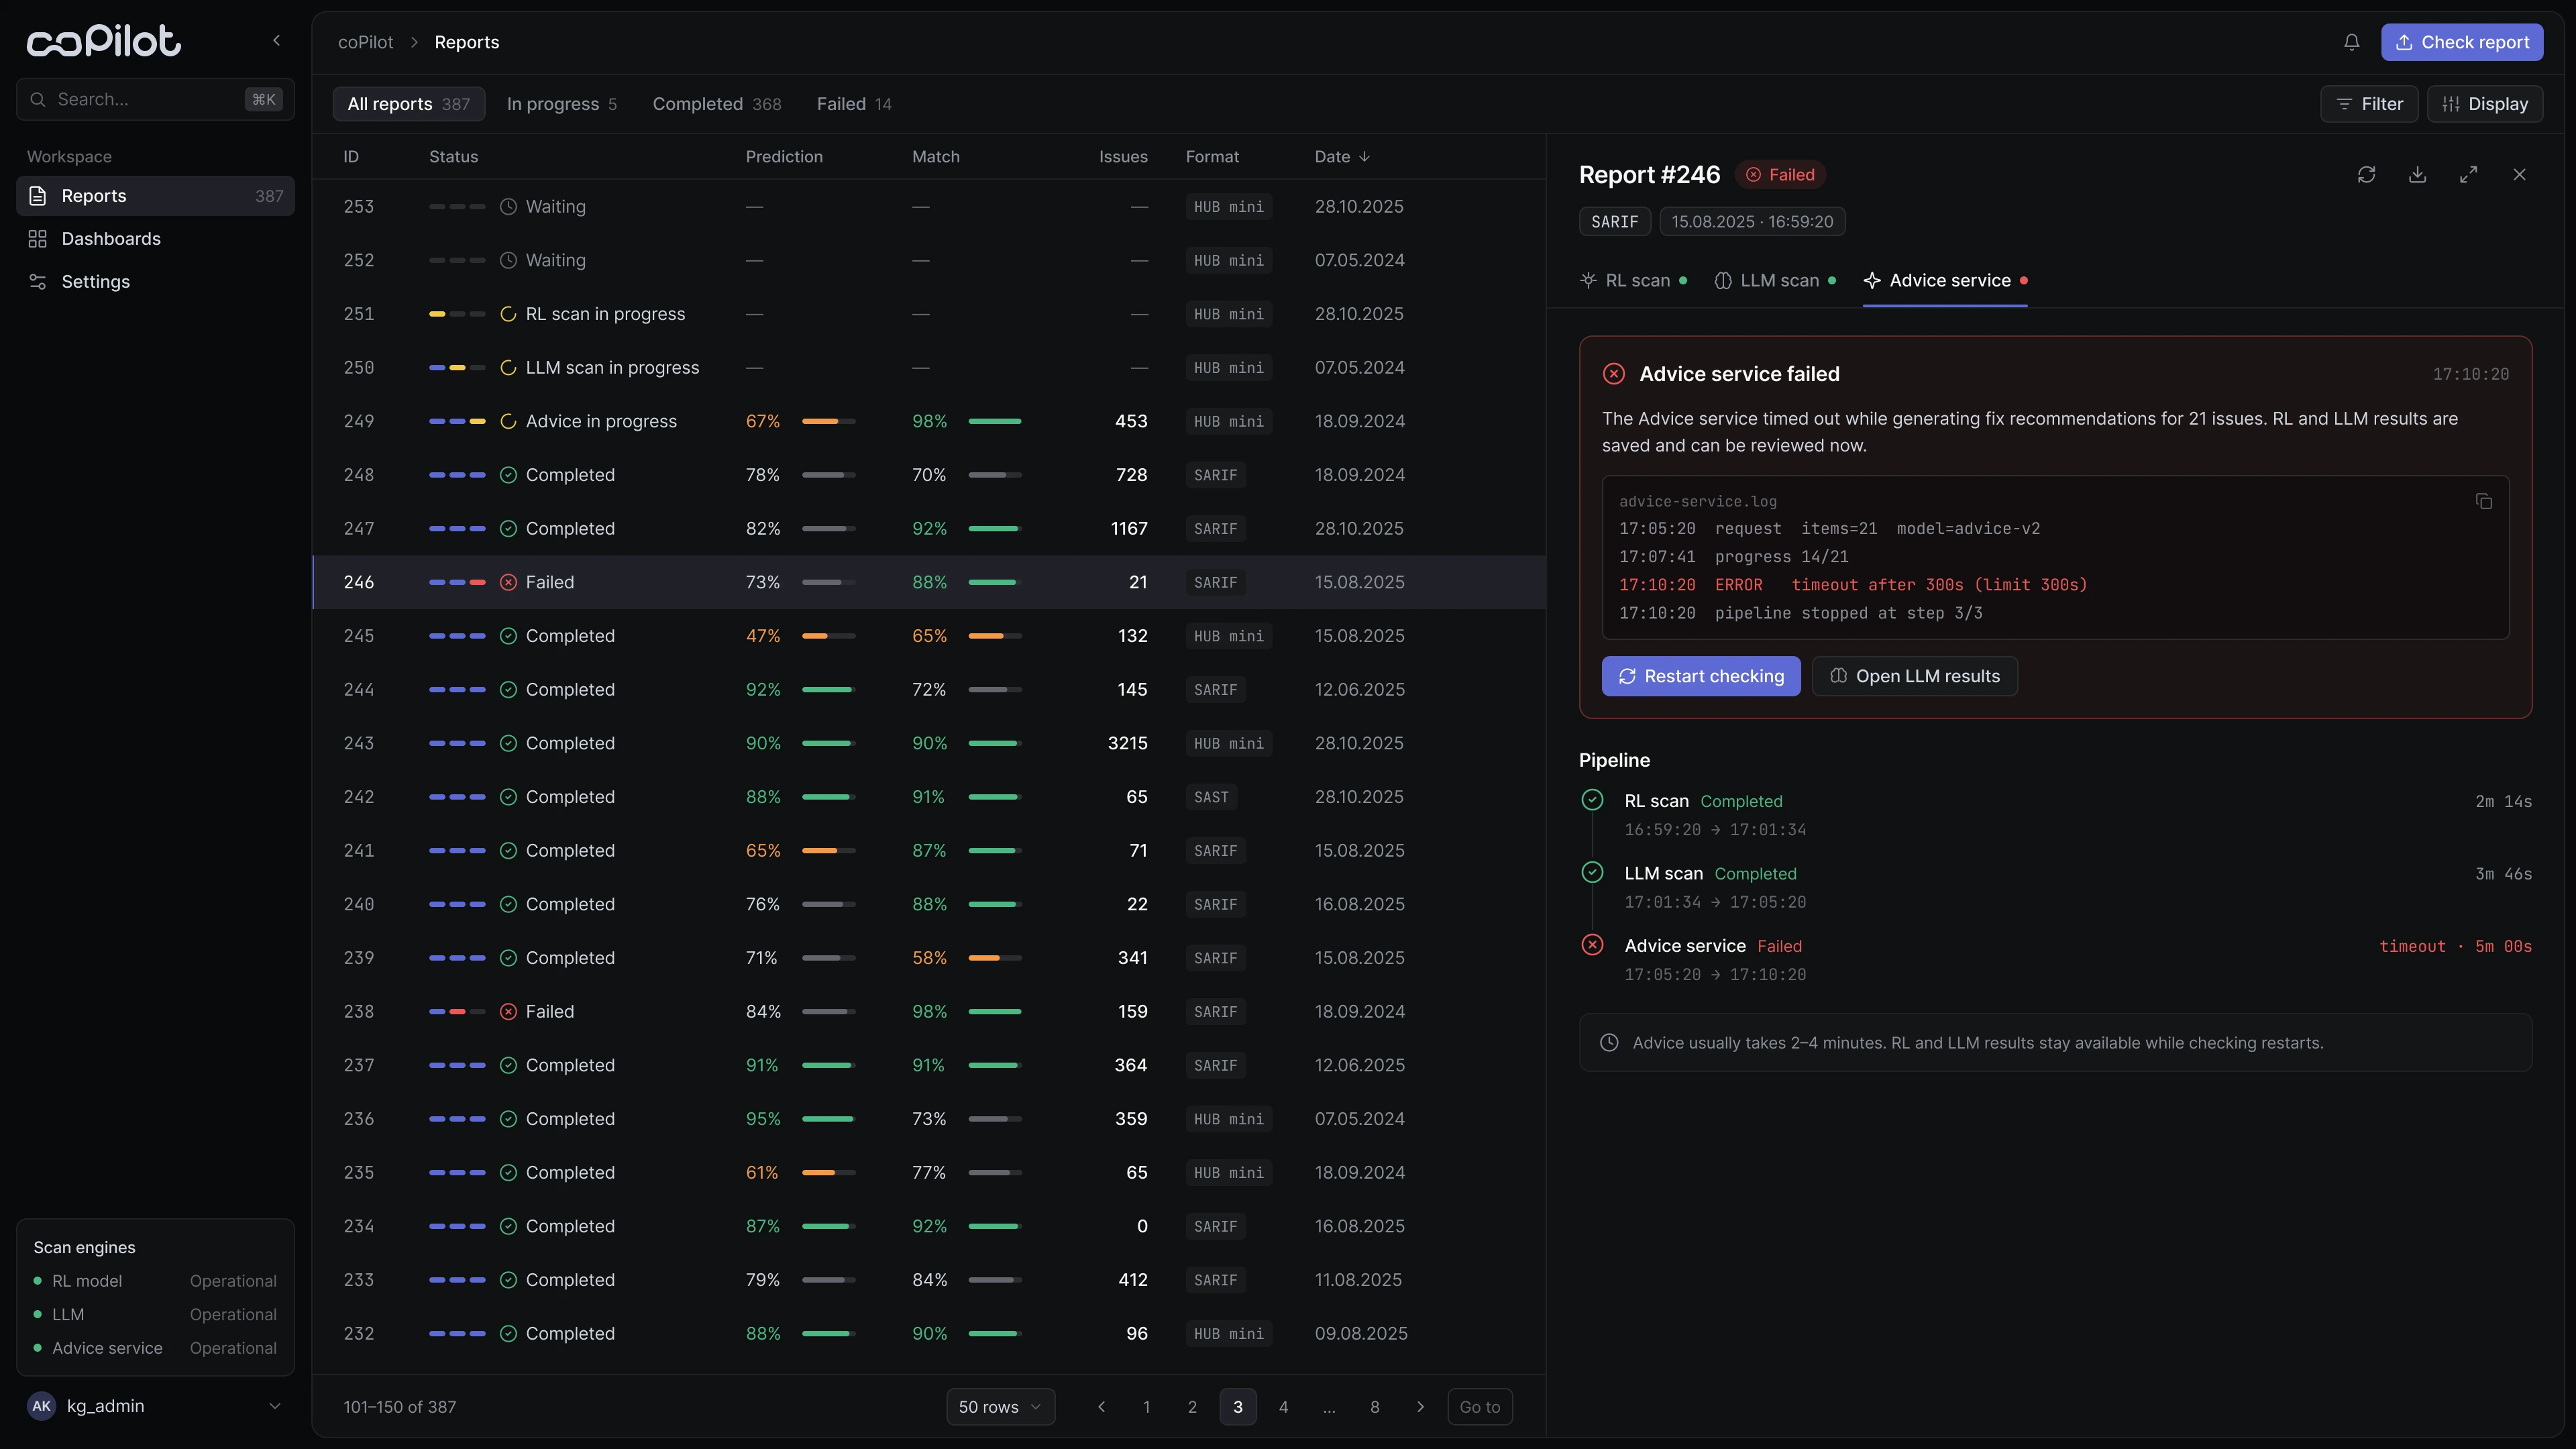
Если один из движков падает, аналитик видит, на каком этапе, почему и что уже готово. Результаты RL и LLM остаются доступны, а проверку можно перезапустить прямо из карточки ошибки.
Система состояний
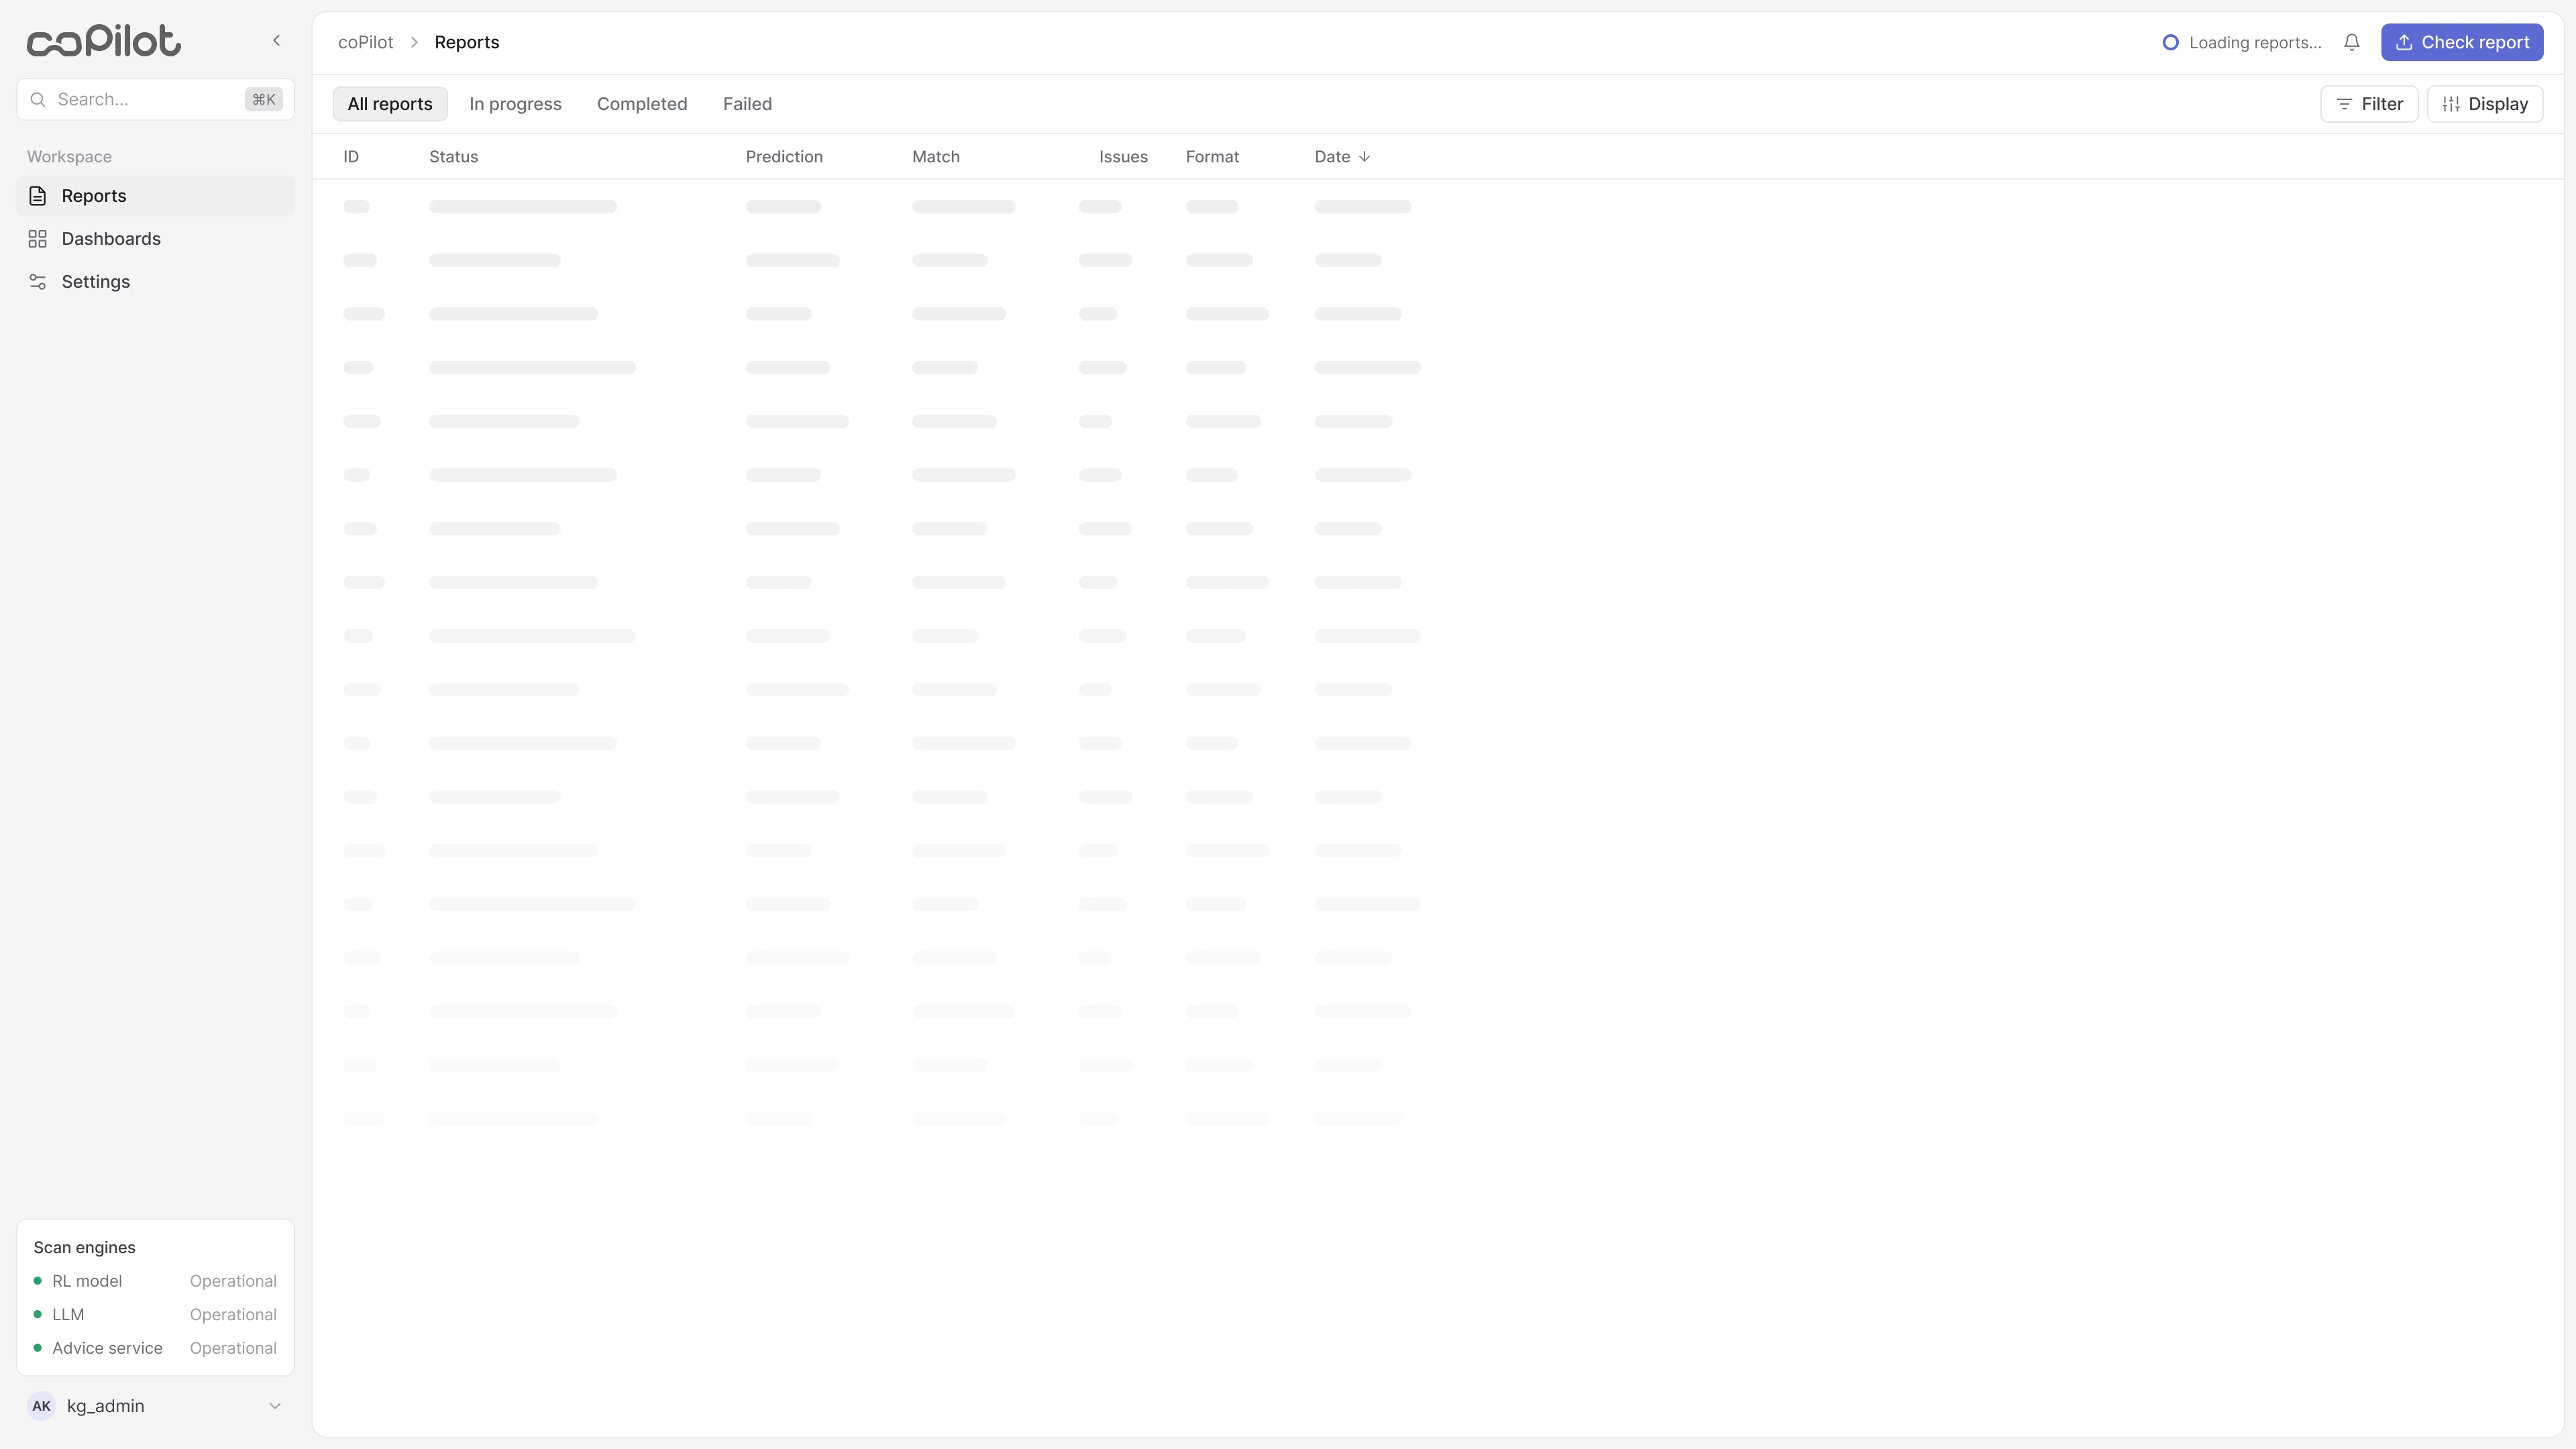
Я описала 8 состояний — от «ожидает» и «в работе» до «сбой», «пусто» и «ноль находок» — и применила одну логику на всех уровнях: обработка, отчёт, находка. Так сложность растёт без новых правил для каждого экрана.
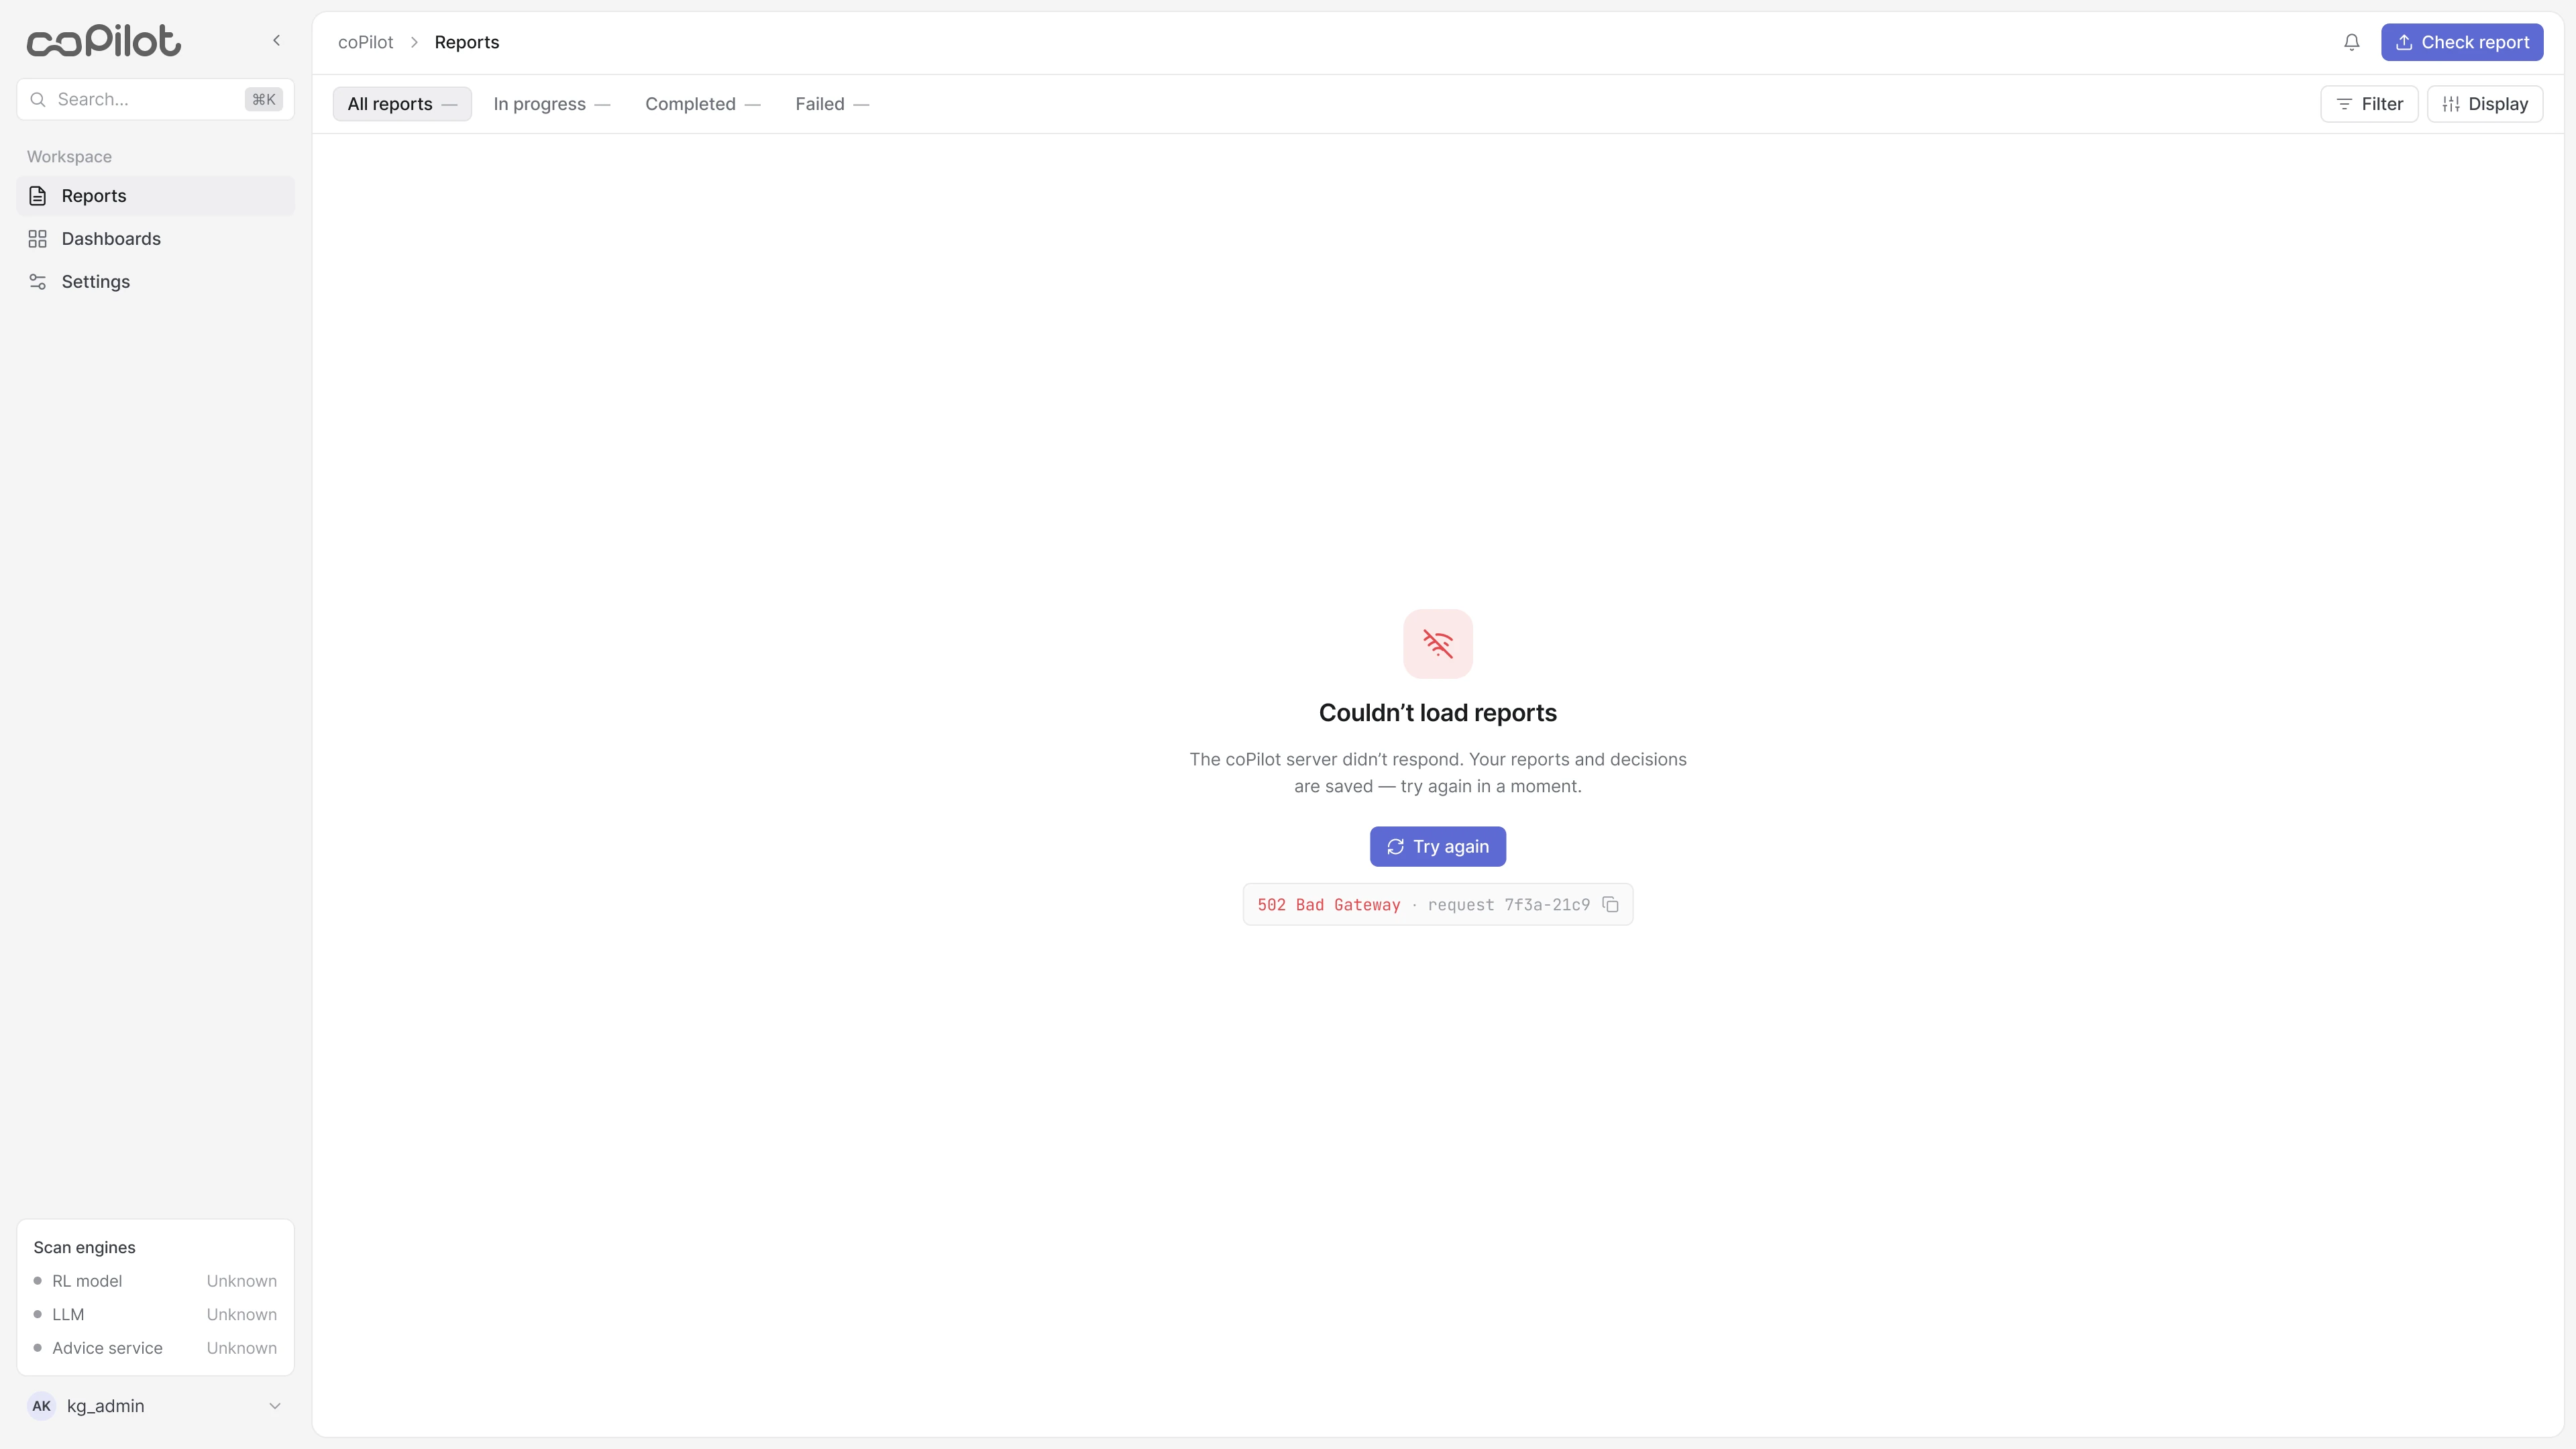
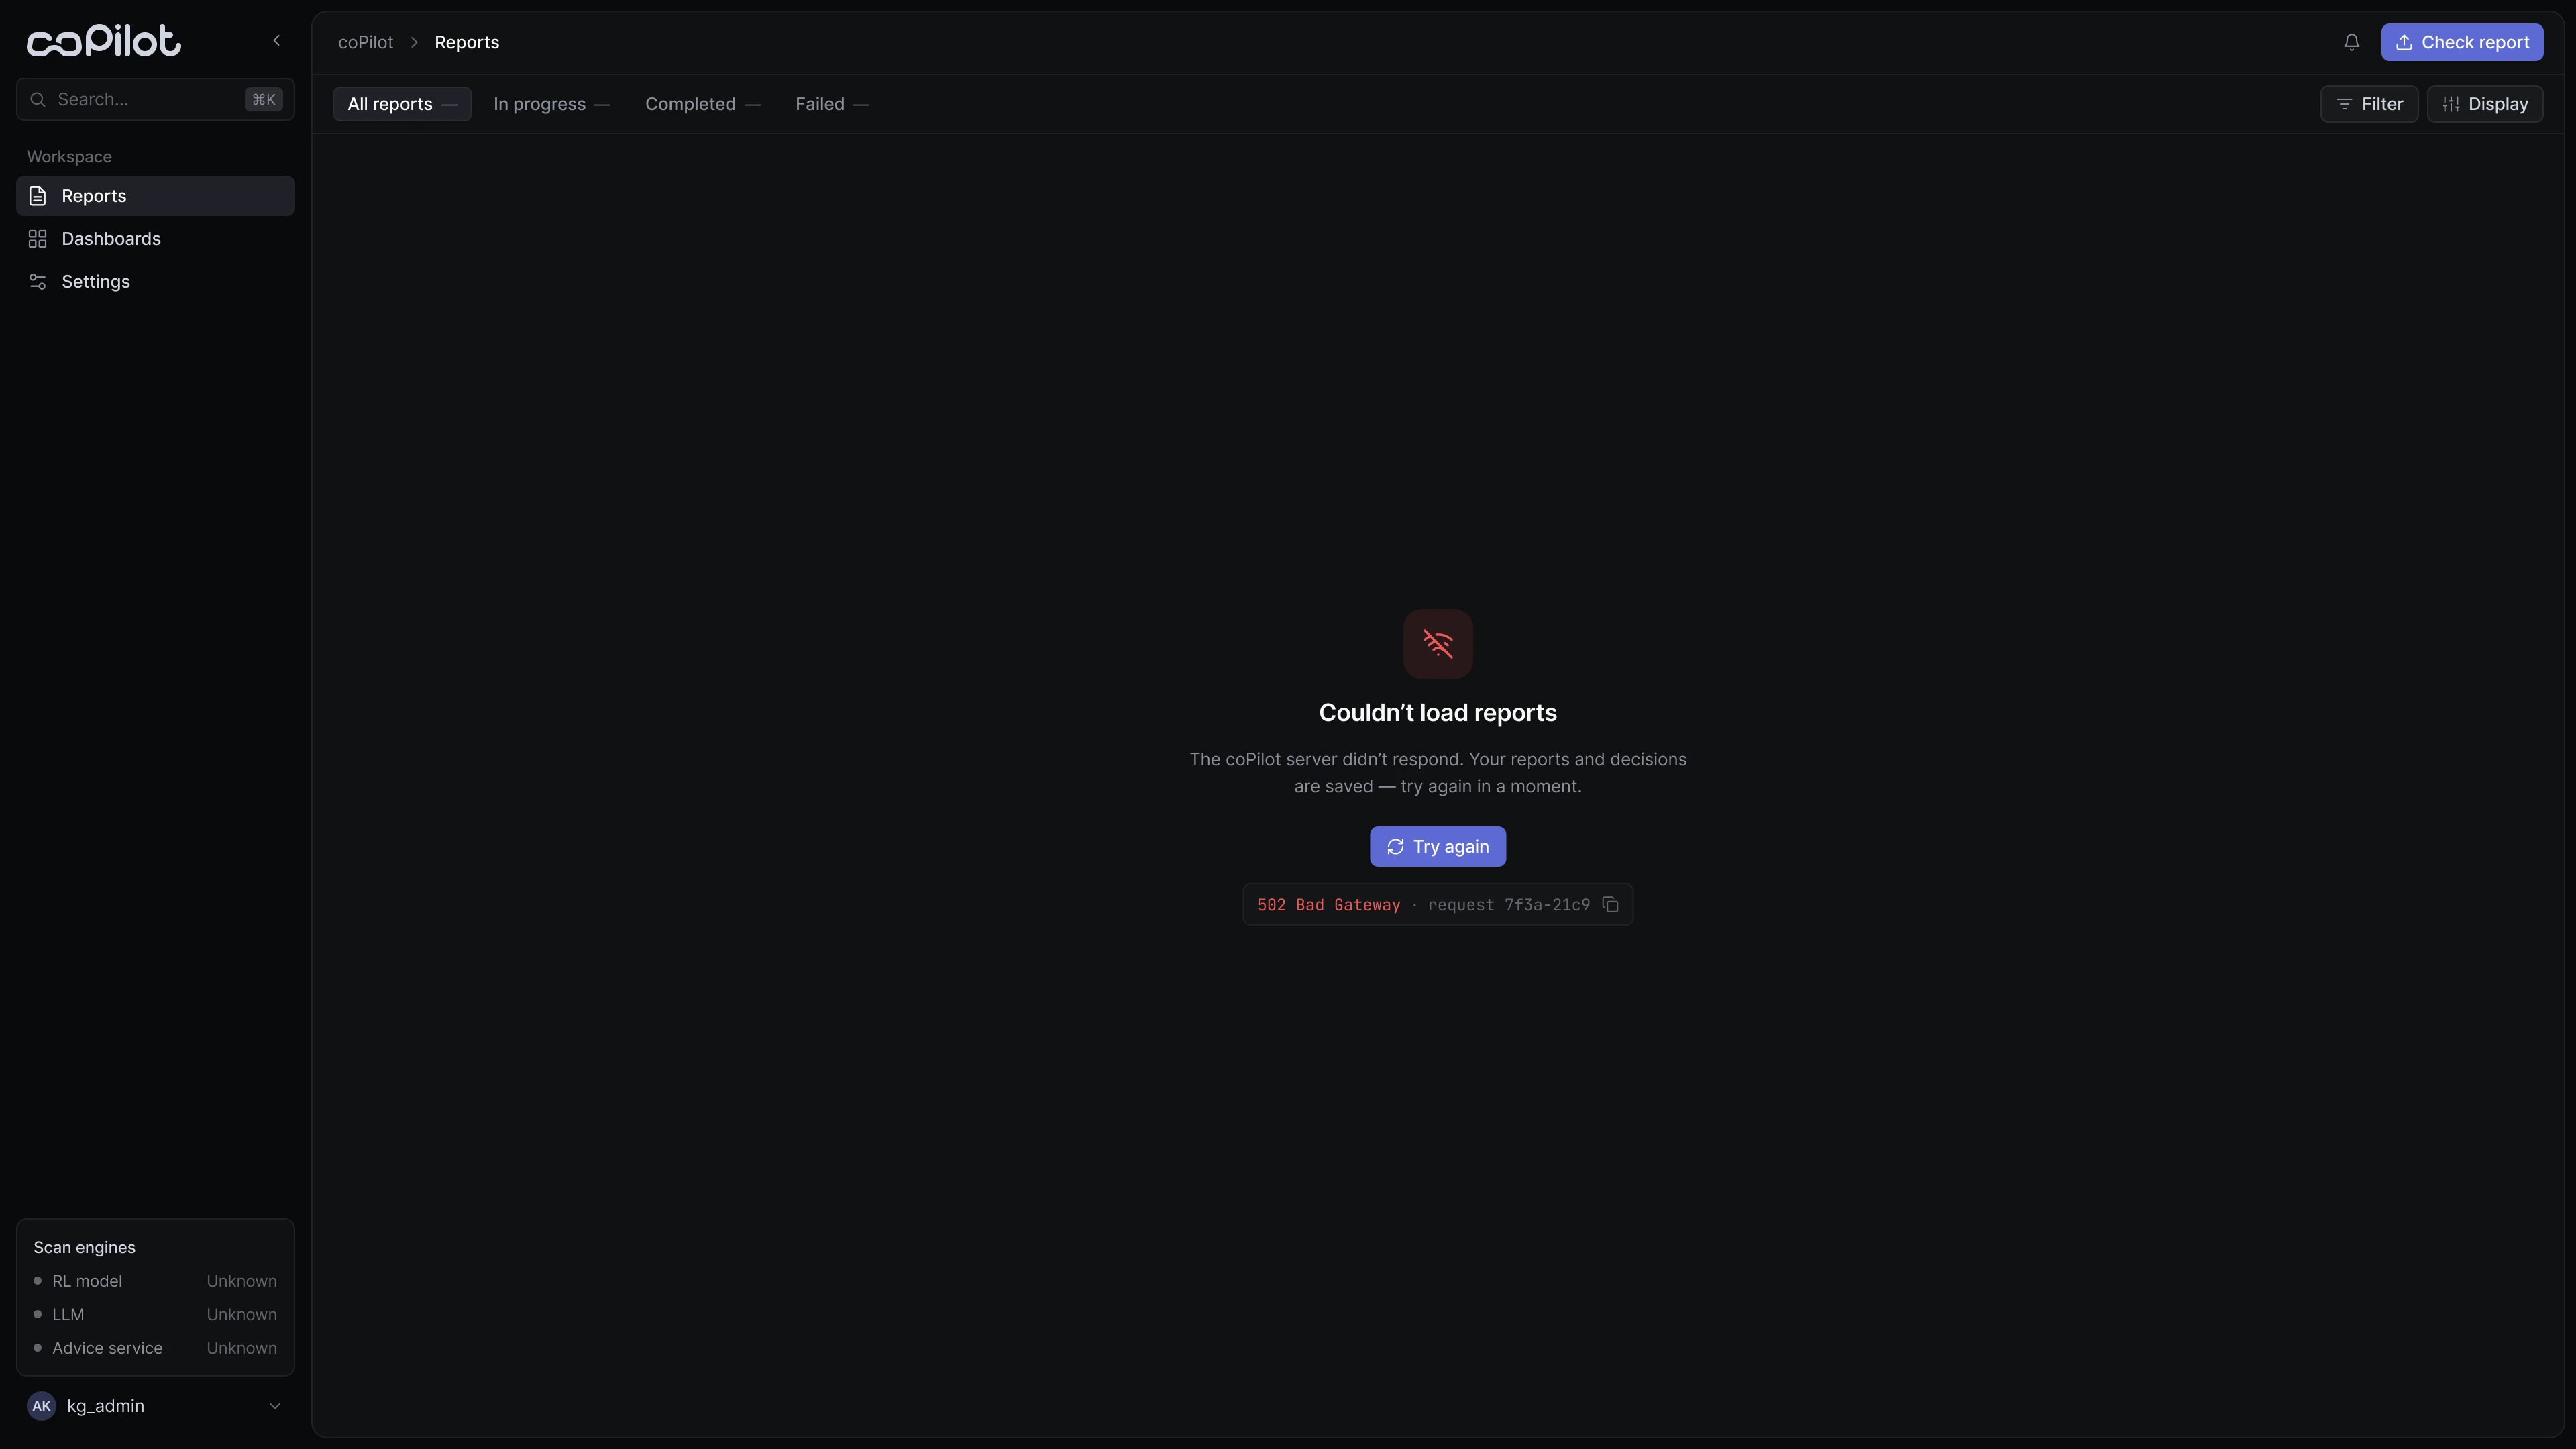
Светлая и тёмная тема
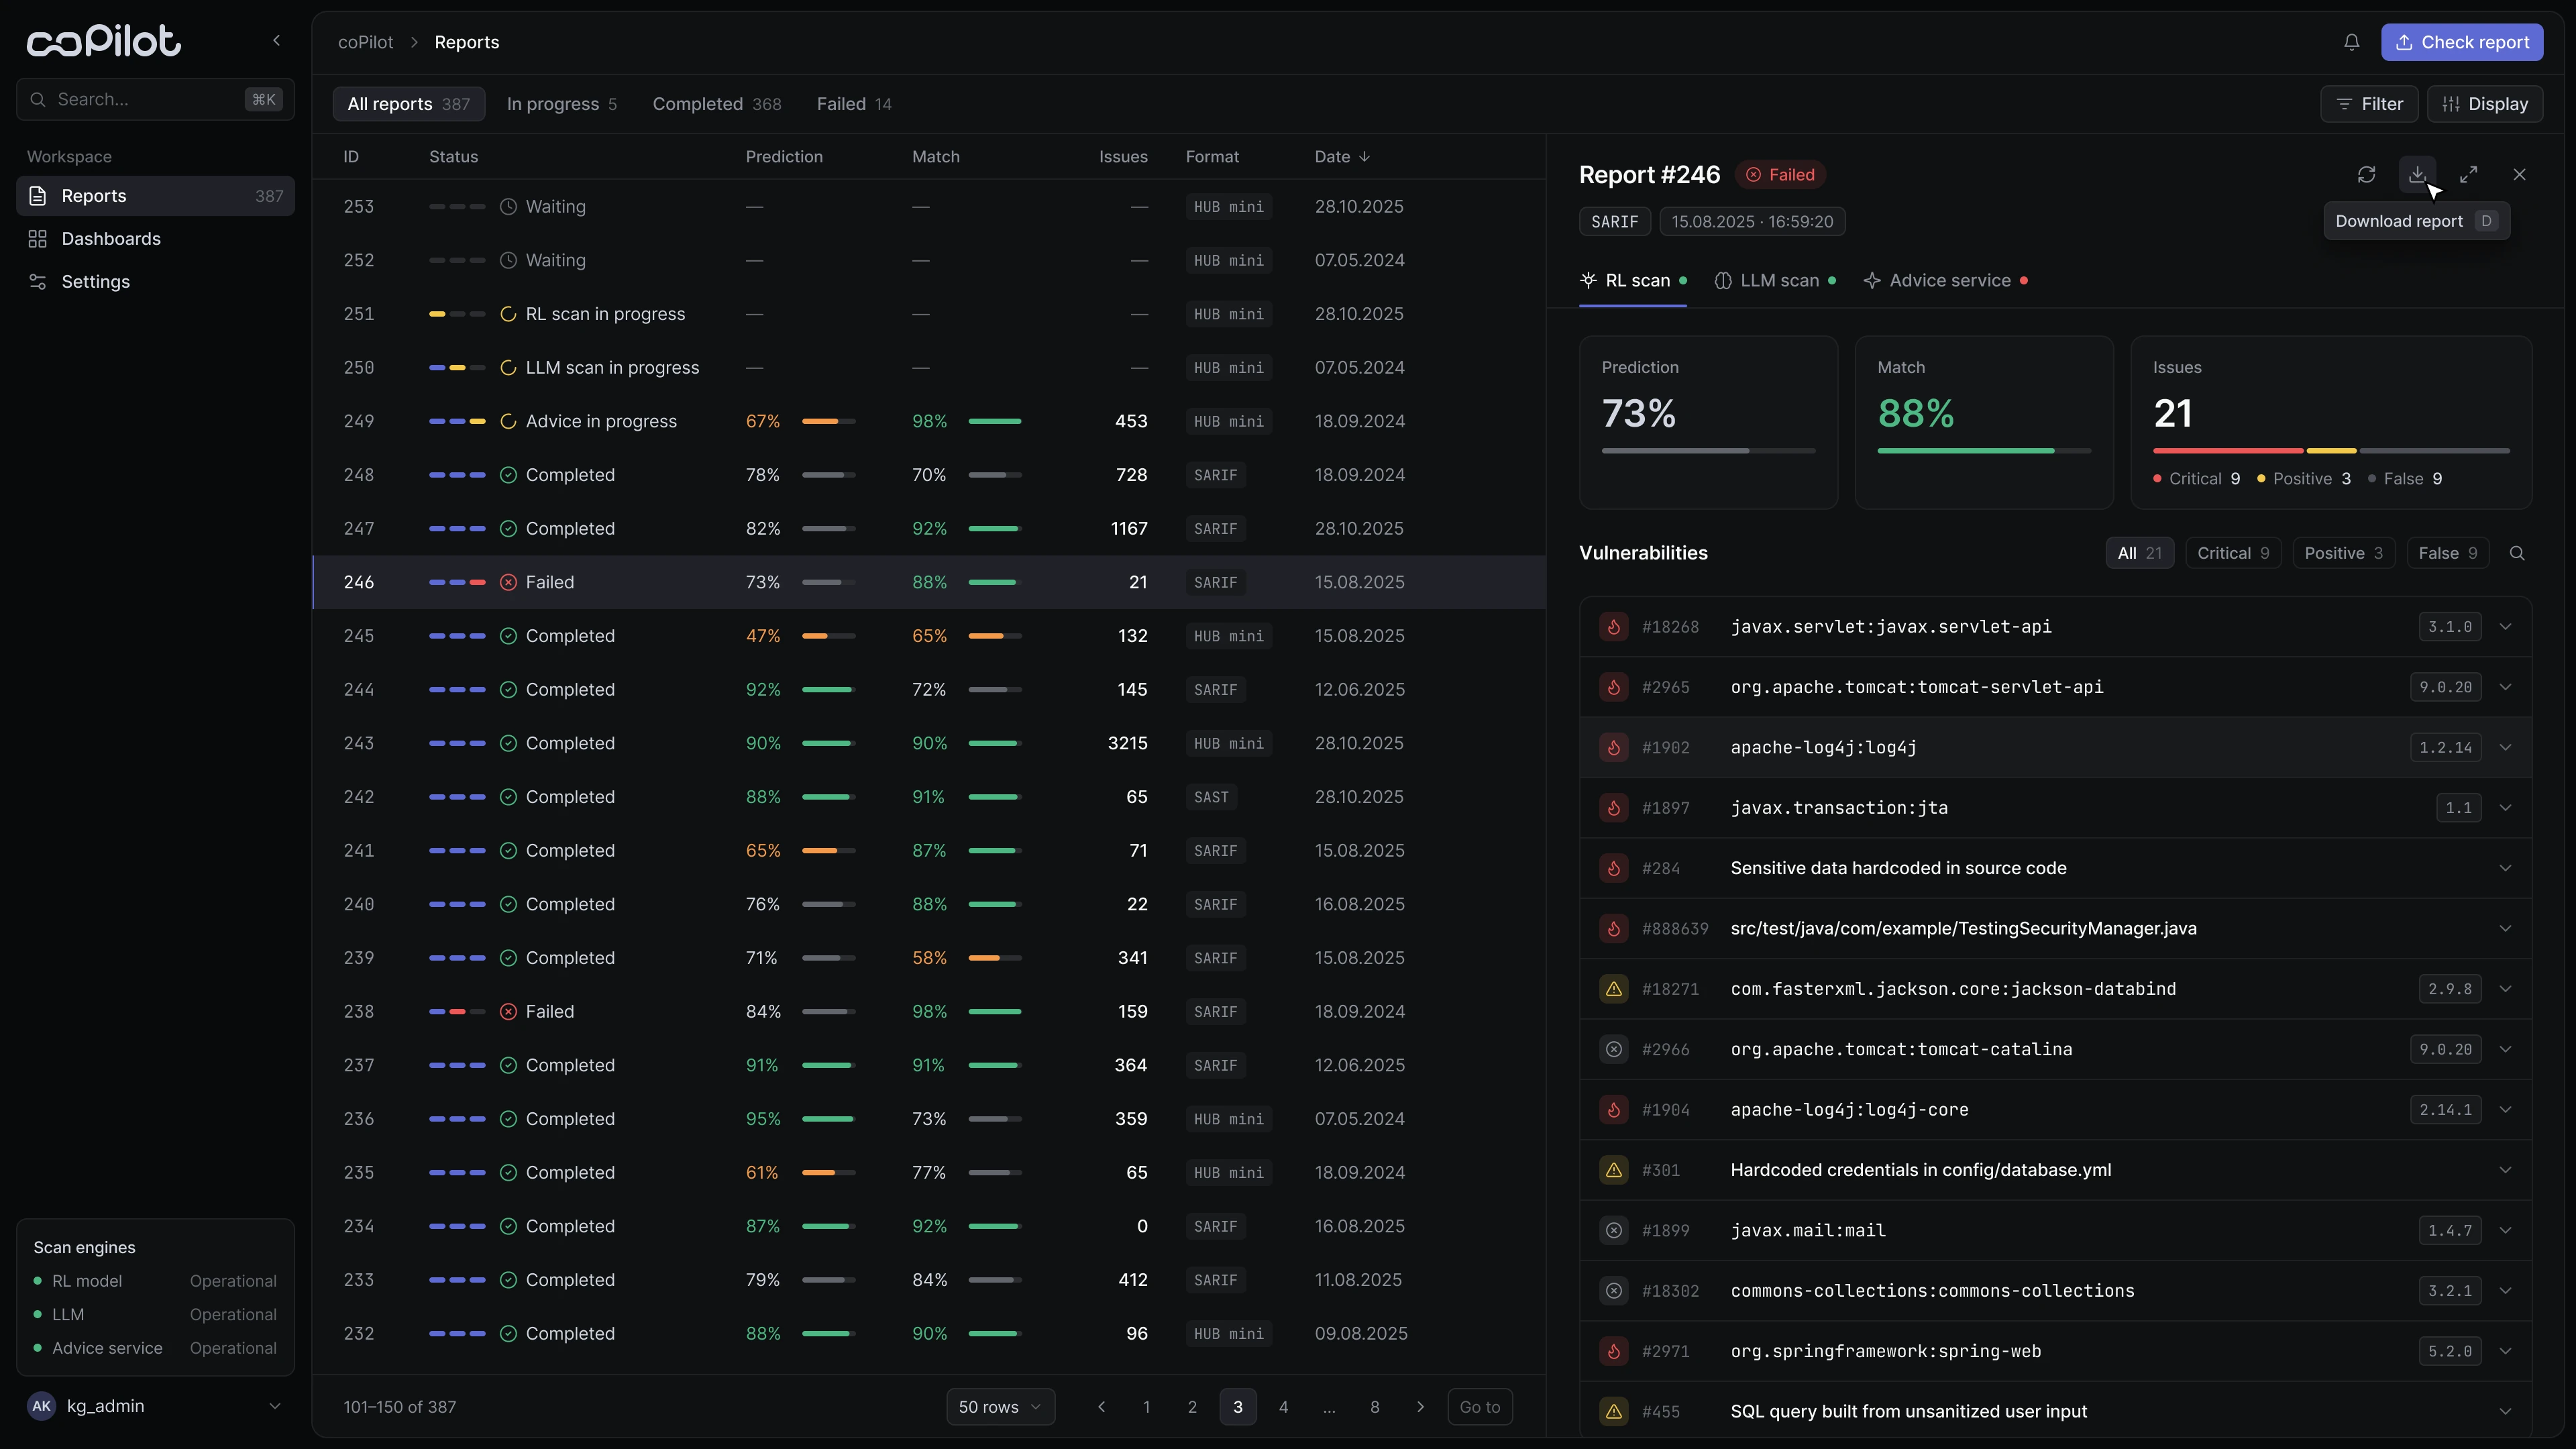
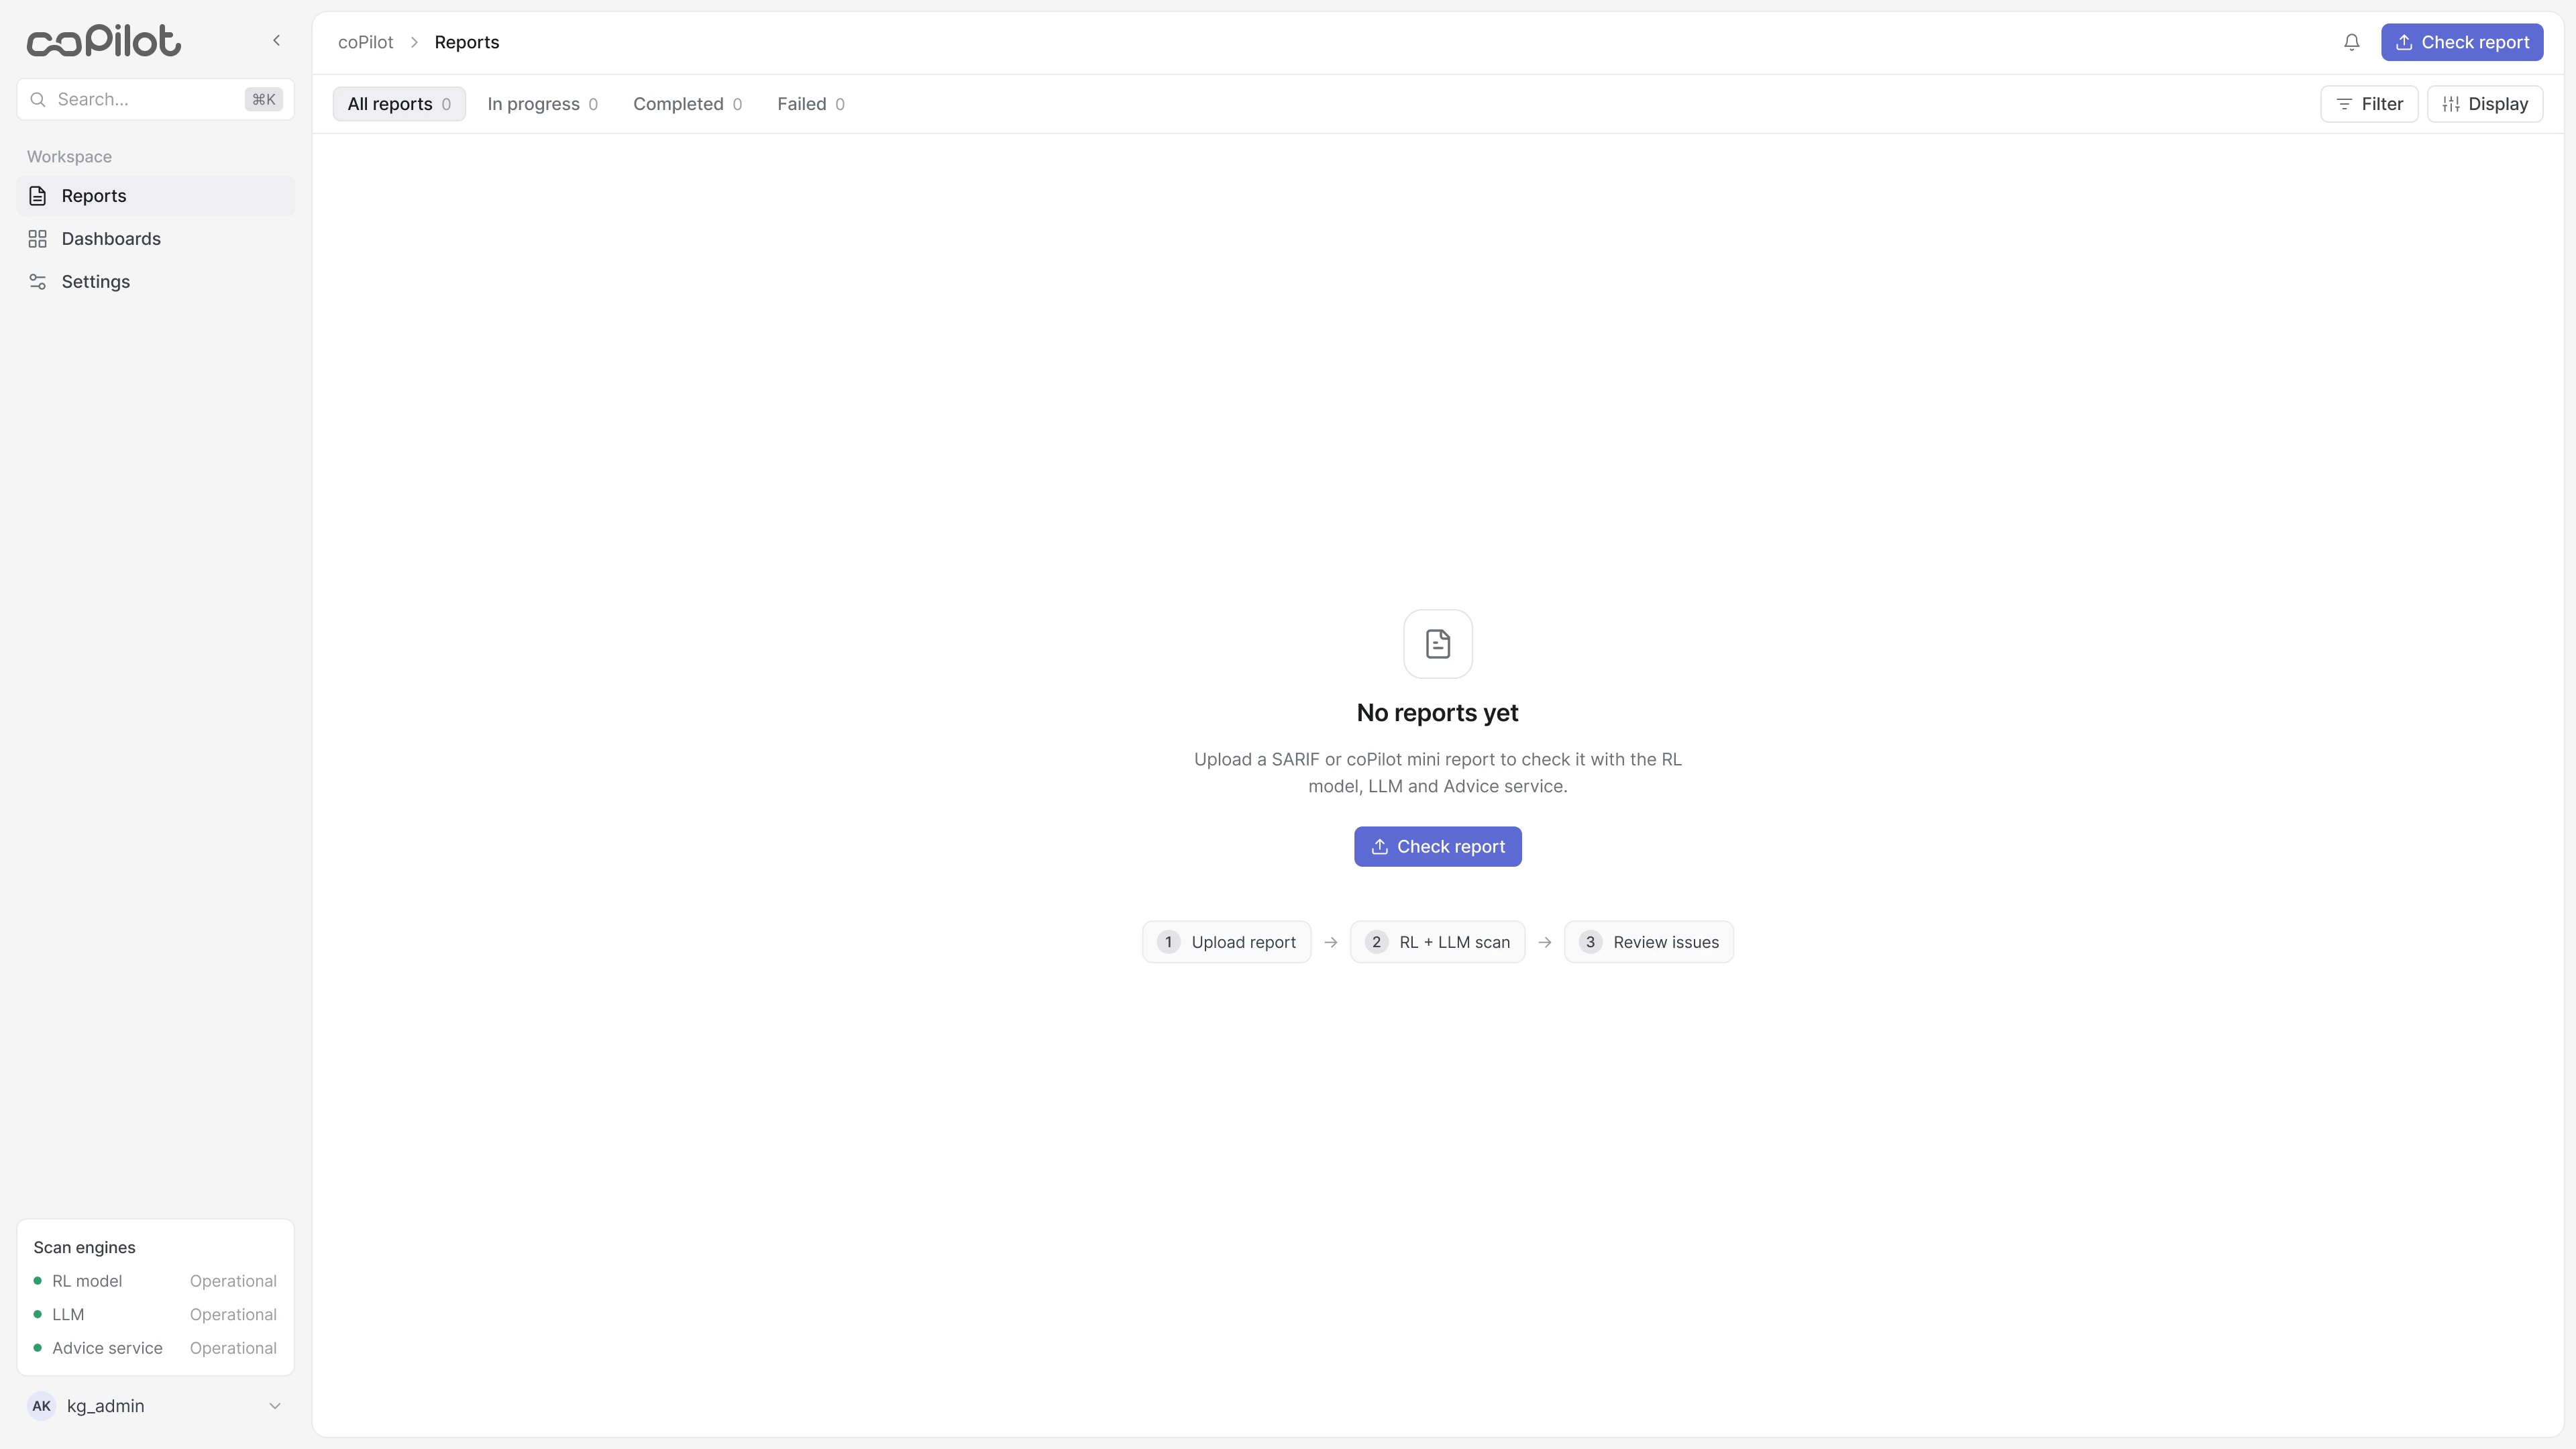
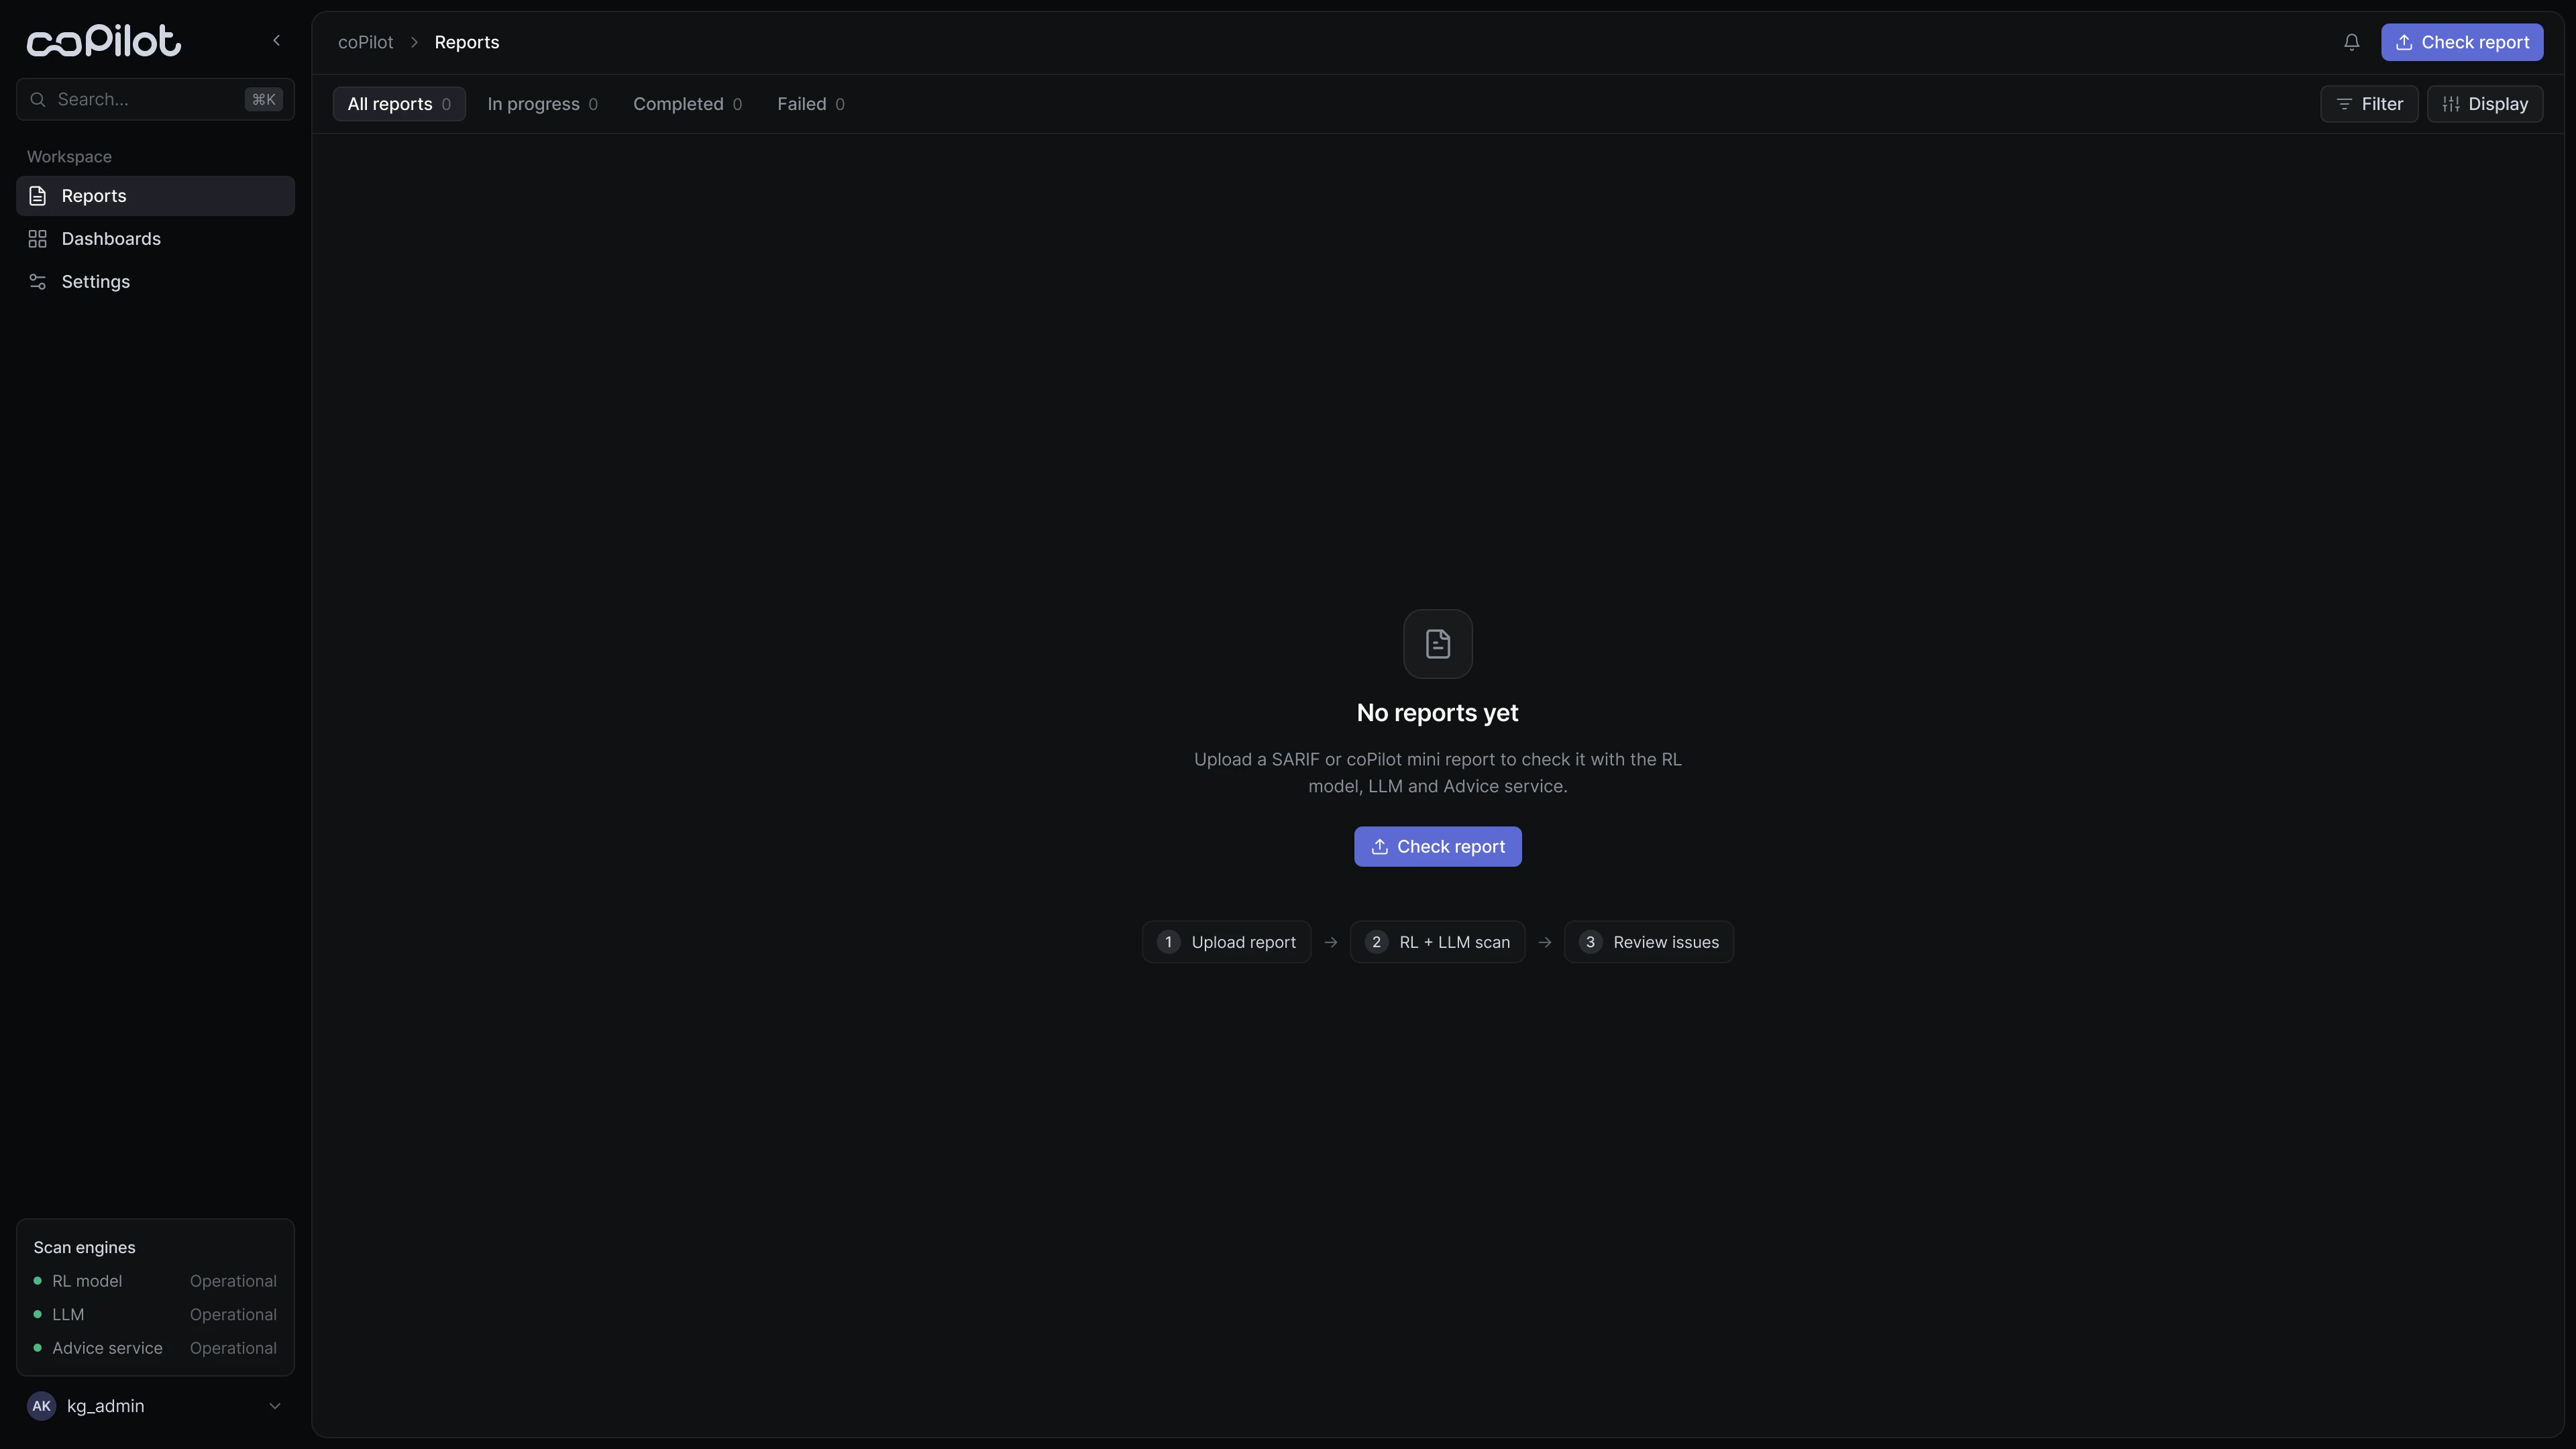
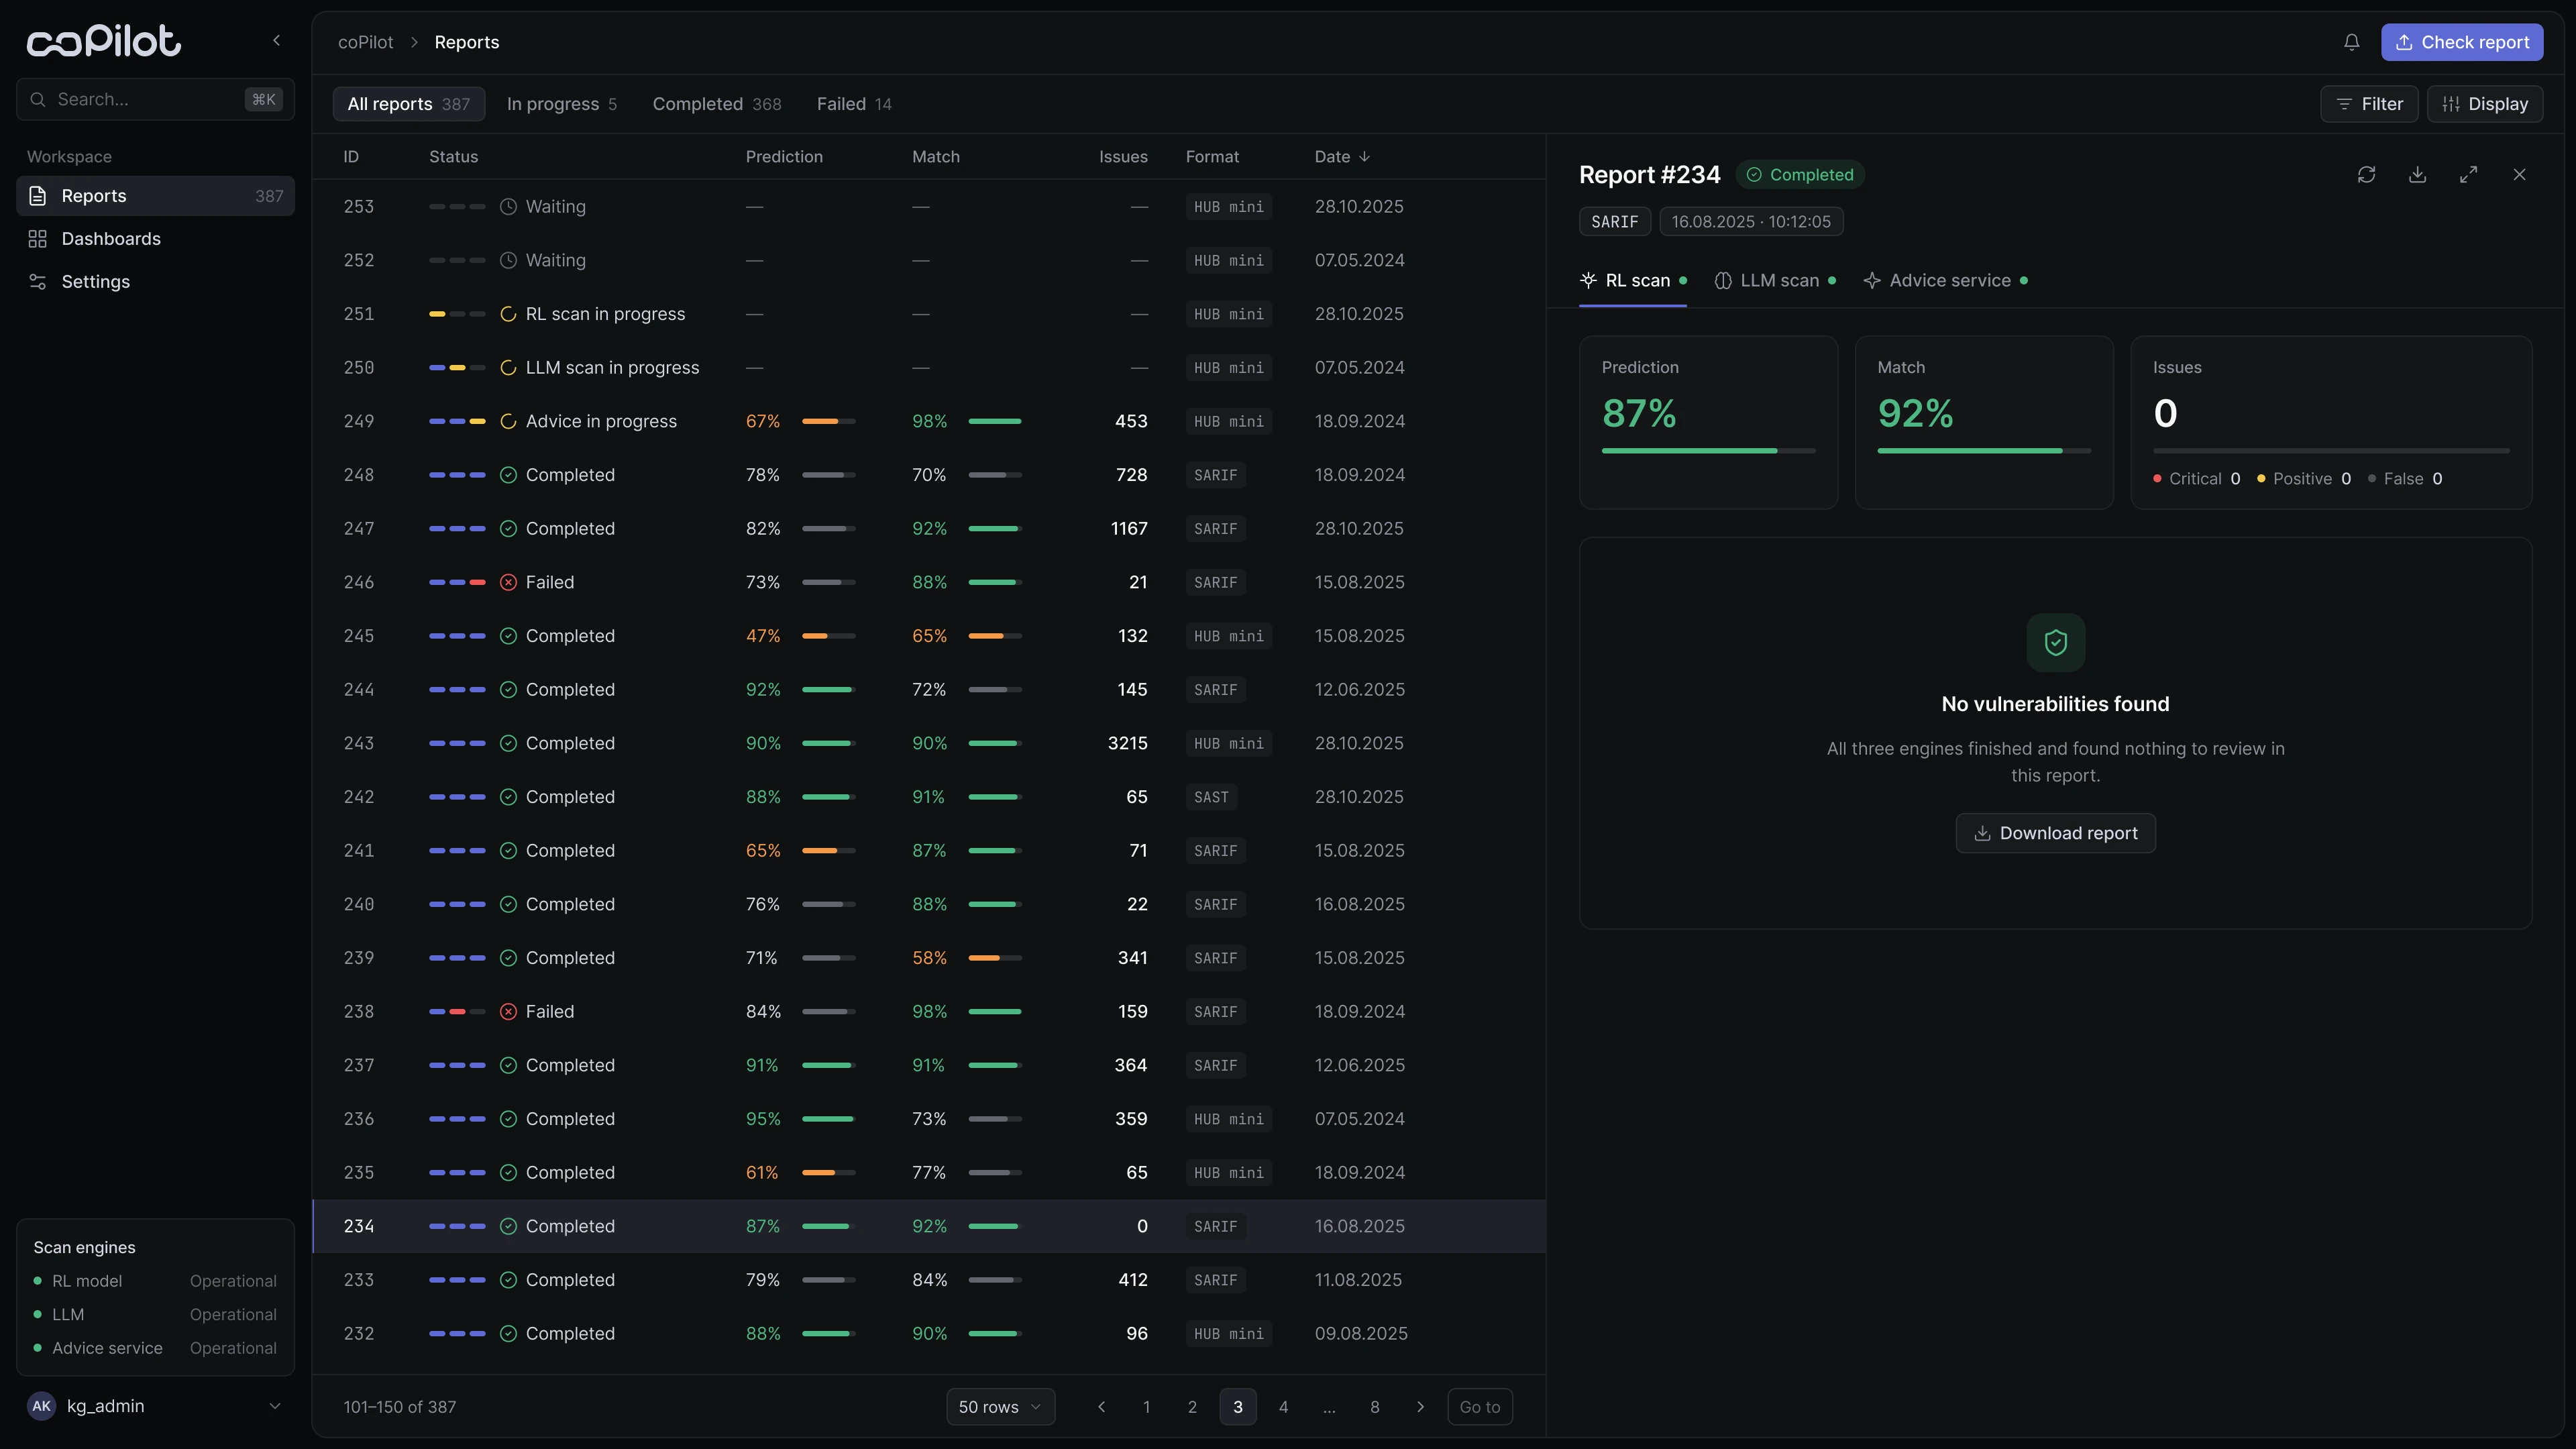
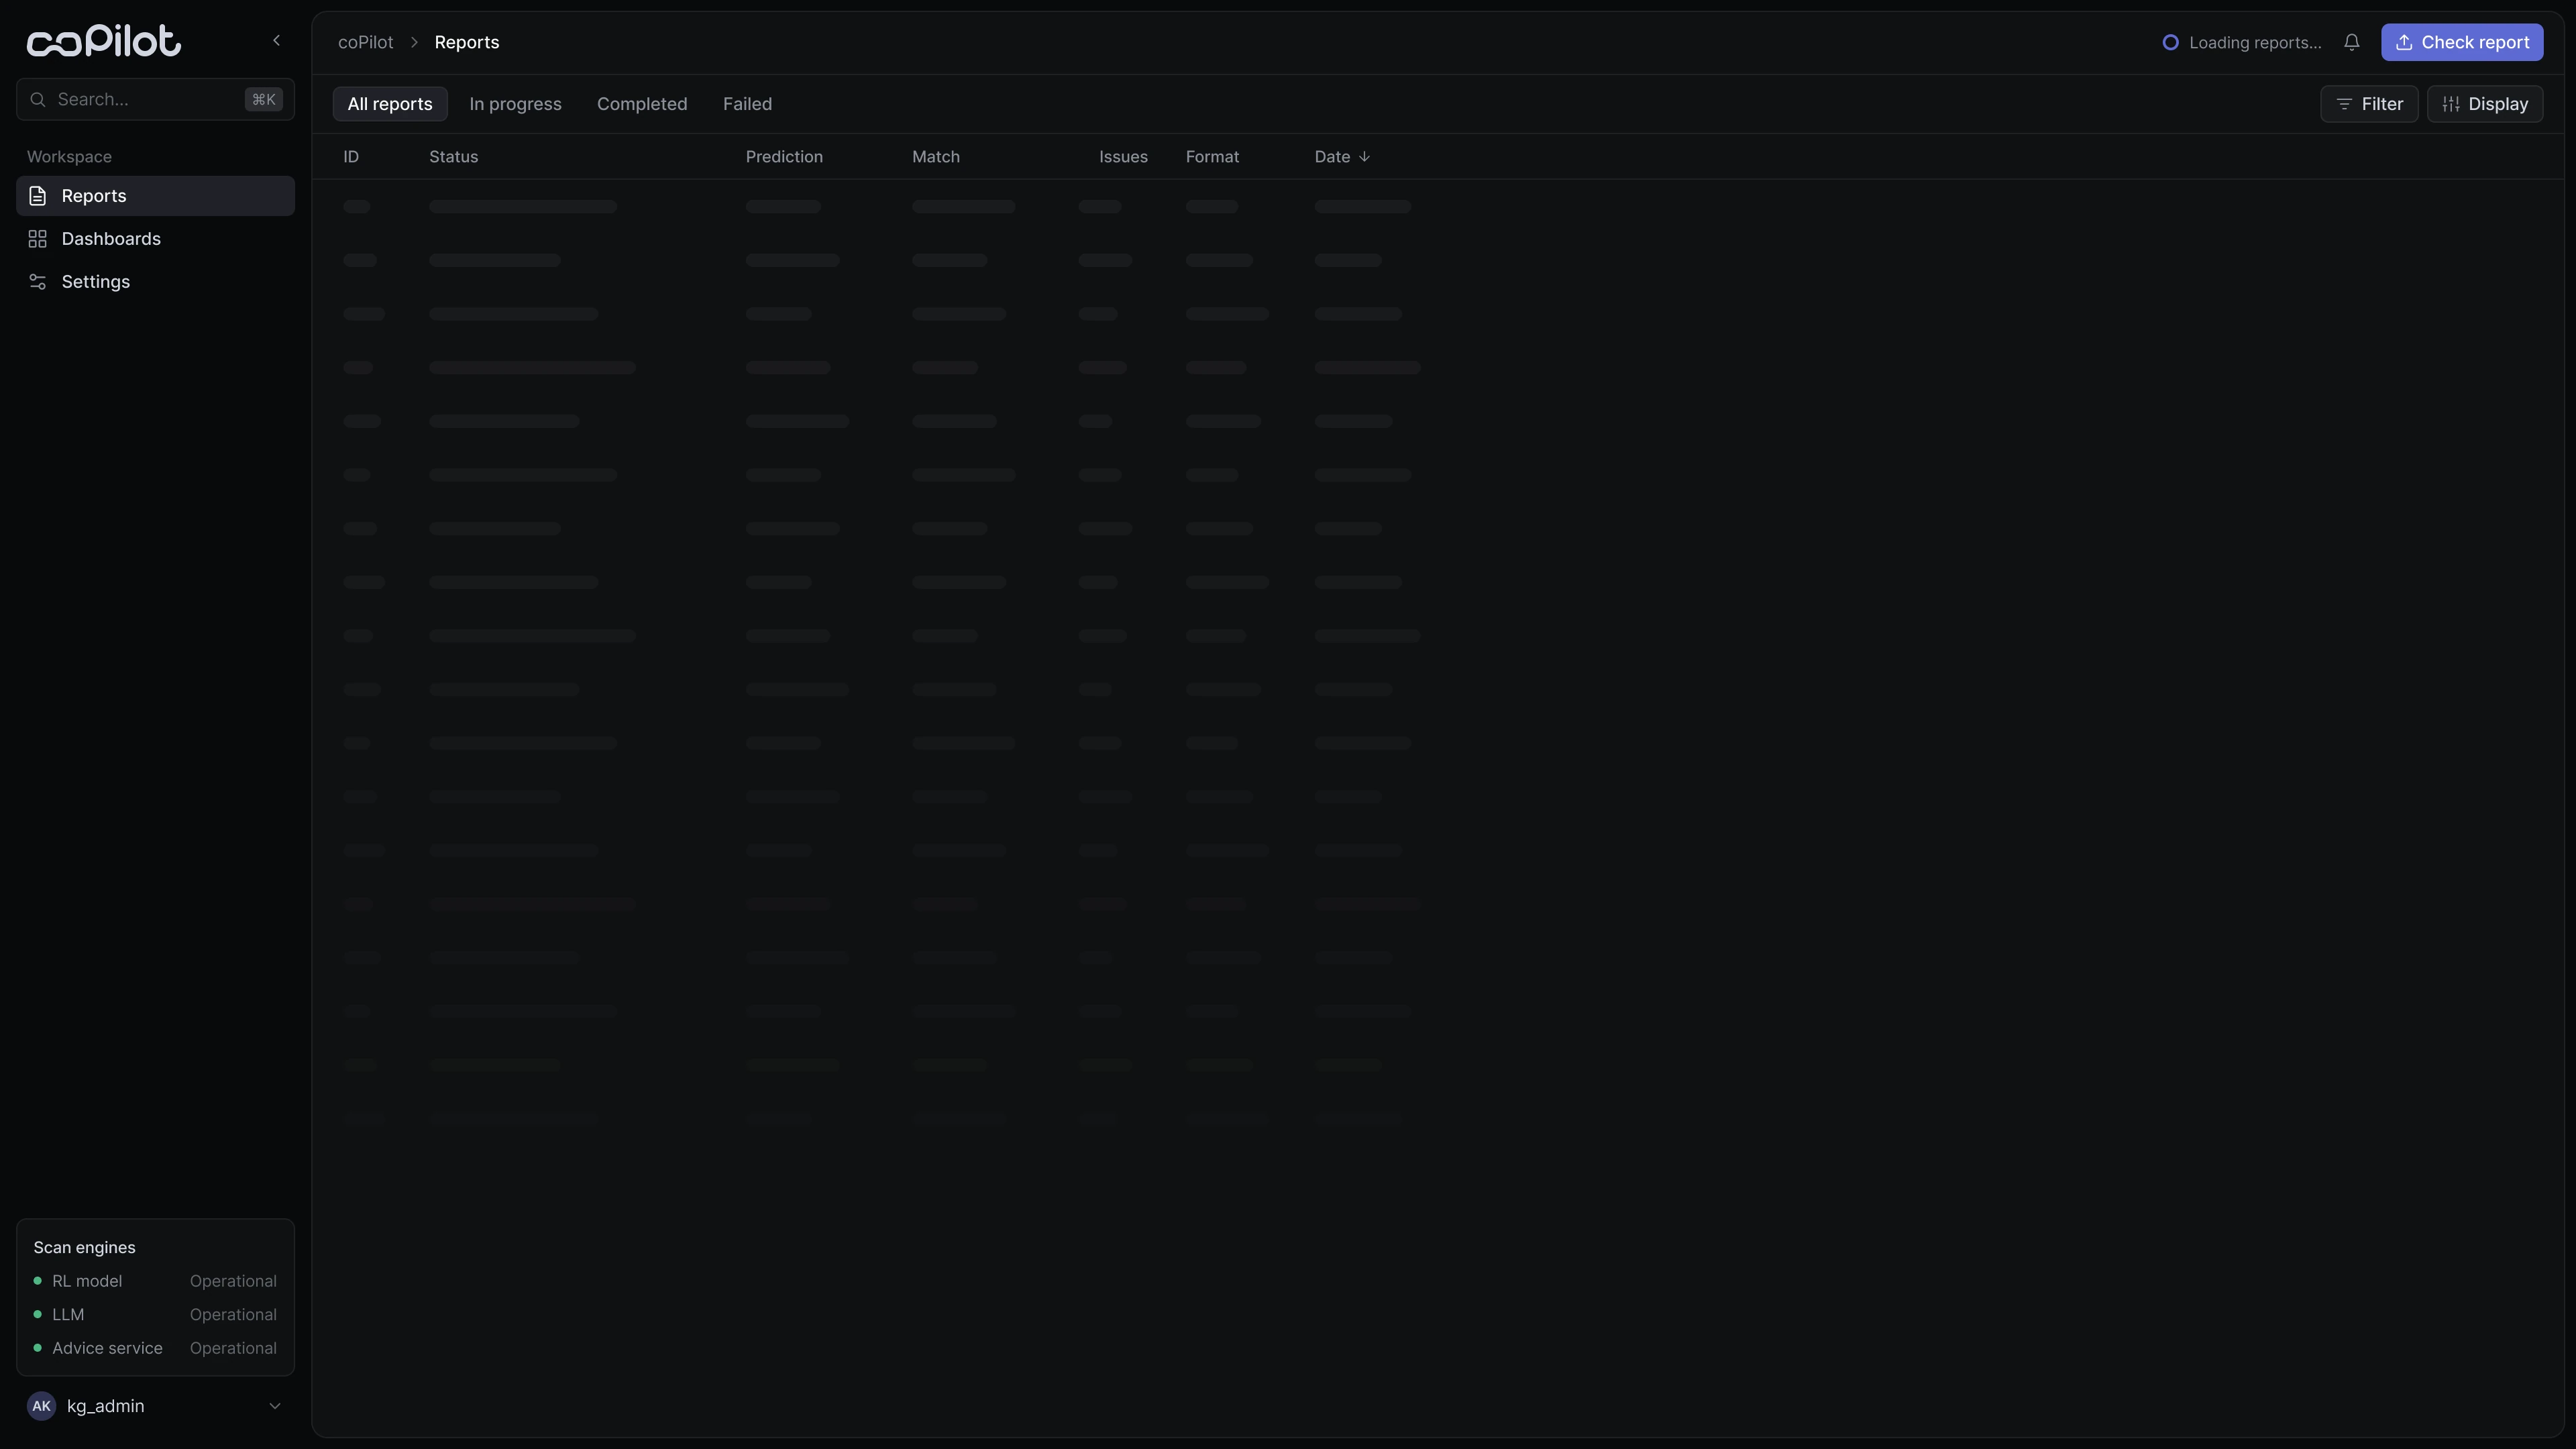
Интерфейс собран на семантических токенах — фон, поверхность, граница, текст, акцент, статусы. Поэтому обе темы получаются из одной системы: меняются значения цветов, а не макеты. Статусные цвета в светлой теме темнее, чтобы оставаться читаемыми на белом.
Результат
- ≈ −60% времени на разбор большого скана: с 6–8 до 2–3 часов.
- ≈ 2 из 3 находок закрываются без открытия кода: очевидные случаи решаются прямо по результатам проверки.
- 100% решений прослеживаемы: разбор можно защитить на аудите.
- Единая система из 8 состояний: одна спецификация для разработки вместо макетов под каждый случай.
Чему я научилась
Сложность не исчезает, когда упрощаешь интерфейс. Её нужно структурировать. Разбор ускорился не потому, что AI решает за человека, а потому, что аналитик видит, на чём основан вывод.